ホーム > 生成AI・IT活用 > LLMOでは、作るのはClaudeのMAX、確かめるのは無料のChatGPT
LLMOでは、作るのはClaudeのMAX、確かめるのは無料のChatGPT
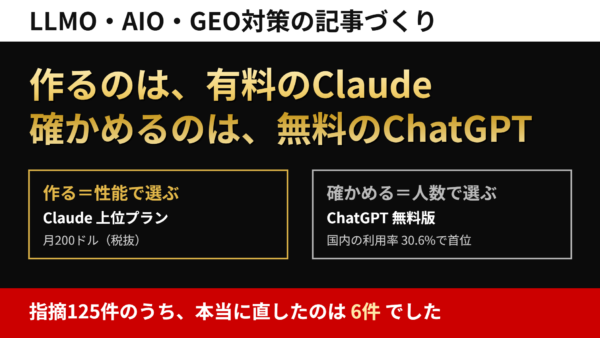
- 作る側=性能で選ぶ。結果が目的なので、有料でも上位のものを使います(当社はClaudeの月200ドルのプラン)。
- 確かめる側=利用者の多さで選ぶ。国内の利用率首位はChatGPT(30.6%)。多数派が見ている画面で、自社の記事がどう読まれるかを見ます。
- 返ってきた指摘は、そのまま直しません。12回とも無料版のChatGPTに本文だけを渡し、指摘125件のうち52件(約4割)は「すでにやってあること」でした。本当に直したのは6件です。
LLMO・AIO・GEO対策では、道具を役割で選びます
生成AIに読まれることを意識した記事づくりを、当社ではLLMOと呼んでいます。AIO(AI Optimization)やGEO(Generative Engine Optimization)、AEOと呼ばれることもあり、指している中身はほぼ同じです。言葉の違いと取り組む順番はSEO・AEO・GEO・LLMO対策|違いと、6つの順番にまとめてあるので、ここでは呼び方の話はしません。
この記事で書くのは、もっと手前の、道具の選び方です。LLMO・AIO・GEO対策の記事を作るとき、当社は生成AIを2か所で使っています。作るときと、確かめるとき。そしてこの2つを、まったく別の基準で選んでいます。
| 役割 | 何を基準に選ぶか | 当社が使っているもの | 費用 |
|---|---|---|---|
| 作る(下書き・構成・HTML) | 性能。結果が目的なので、いちばんいいものを使う | Claudeの上位プラン | 月200ドル(税抜) |
| 確かめる(公開前の講評) | 利用者の多さ。多数派が見ている画面で確かめたい | ChatGPTの無料版 | 0円 |
ここを取り違えると、どちらも中途半端になります。作る側を安く済ませると、結果が出ません。確かめる側を高いものにすると、読者が見ている景色から離れます。目的が違うのだから、選ぶ基準も違って当たり前だ、というだけの話です。
そもそも日本では、AIの答えをそのまま信じている人のほうが少数派です。総務省の『令和8年版 情報通信白書』(2026年7月24日公表)の「生成AIサービスを利用する理由(国別)」を見ると、日本で「内容が正確・中立そうだと感じる」を理由に挙げた割合は12.7%で、アメリカ24.8%・ドイツ19.5%・中国32.0%と比べて4か国で最も低い数字でした。疑いながら使っているのは、いたって普通のことです。だからこそ「では、どう確かめるか」を決めておく必要があります。
出典:総務省『令和8年版 情報通信白書』図表「生成AIサービスを利用する理由(国別)」(2026年7月24日公表)原典ページ。数値は同ページで公開されているデータ(f00009.csv)を取得して、日本12.7%・米国24.8%・ドイツ19.5%・中国32.0%を2026年9月14日に確認しました。この設問の回答者数は原典に記載がありません。
作る側に、有料でいちばんいいものを使う理由
「無料でもそこそこ書けるのに、なぜ払うのか」とよく聞かれます。答えは単純で、目的が結果だからです。記事づくりのゴールは、書き上げることではなく、検索やAIの回答に出て、問い合わせにつながることです。そこが変わらないなら、道具代を削った意味はありません。
実際に差が出るのは、うまい表現を書く力ではありません。長い指示を最後まで守れるか、決め事を覚えていられるか、自分の書いたものを自分で点検できるかです。当社の記事には、赤は1色だけ、表には必ず説明文を付ける、図は画像ではなく文字として読める形で作る、といった決め事が何十とあります。これを最後まで守り切れるかどうかで、公開前の手直しの量がまるで変わります。
当社が払っているのは月200ドル(税抜・請求220ドル)の上位プラン1本だけです(2026年9月時点)。ChatGPTとGeminiには課金していません。渡す相手を1つに絞ると、決め事も過去のやりとりもそこにたまっていくからです。どのモデルをどの仕事に使うかはClaudeのモデルの違いと選び方に書いたので、ここでは触れません。
誤解のないように書いておくと、「高いほうが偉い」という話ではありません。作る側は結果で選ぶ、というだけです。次の章で書くとおり、確かめる側では、当社はいちばん安いもの(無料版)を選んでいます。基準が違うからです。
確かめる側が、無料のChatGPTである理由
確かめる側の基準は、性能ではありません。どれだけ多くの人が使っているかです。自社の記事を読む人も、自社のことをAIに聞く人も、いちばん多い環境を使っているはずだからです。
その根拠になる調査があります。サイバーエージェント GEOラボの「生成AI / AI Overview ユーザー利用実態調査(2026年8月期)」では、ChatGPTの利用率が30.6%で首位、次いでAI Mode 28.4%、Gemini 23.2%という結果でした。全国の15歳〜69歳の男女9,278名を対象にした調査です。
| サービス | 利用率 | 当社での役割 |
|---|---|---|
| ChatGPT | 30.6%(首位) | 確かめる側。無料版を使う |
| AI Mode | 28.4% | — |
| Gemini | 23.2% | — |
出典:サイバーエージェント GEOラボ「生成AI / AI Overview ユーザー利用実態調査(2026年8月期)」(調査対象=全国の15歳〜69歳の男女9,278名/調査期間=2026年8月7日〜8月10日/調査方法=インターネット調査/調査機関=株式会社マクロミル)原典ページ。2026年9月14日に原典で数値を確認しました。
そして、有料版ではなく無料版を使います。多くの人が触っているのは無料版のほうだからです。有料版で確かめて「よく書けている」と言われても、それは多数派が見ている景色ではありません。
実際に、無料版に頼むと何が返ってくるか
2026年9月4日に、無料版のChatGPTへ「うちのサイトの記事を1本、読みやすく直して」と頼んでみました。条件を変えて2回です。1回目はログインした状態、2回目は過去のやりとりを引き継がない「一時チャット」。
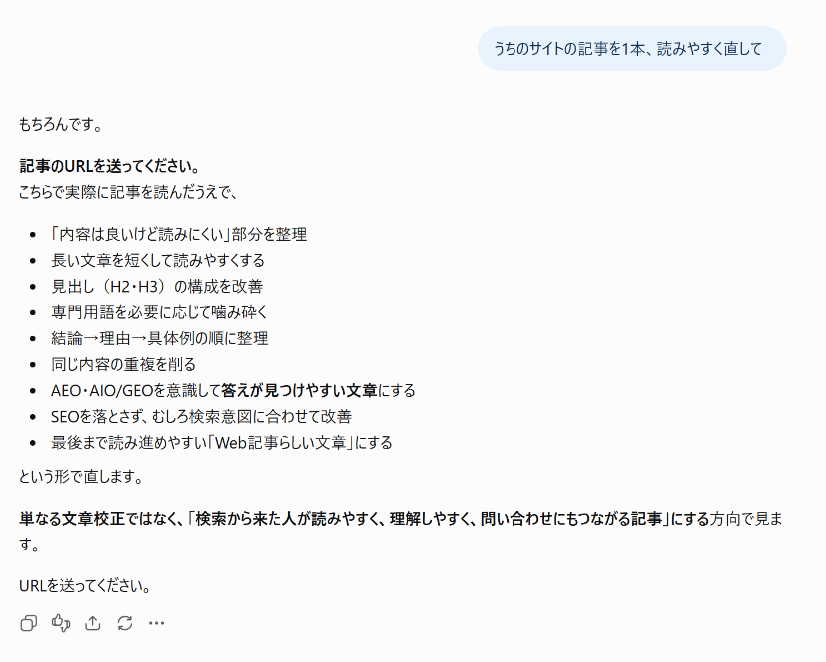
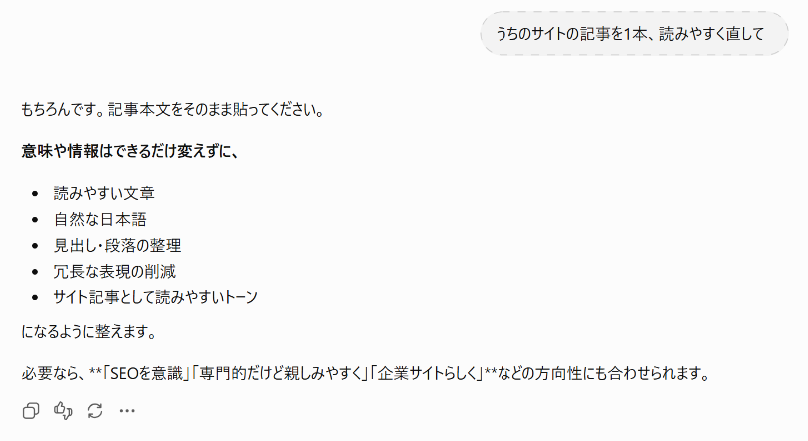
どちらも間違ってはいません。読みにくい部分を整理する、長い文を短くする、結論から書く、AEO・GEOを意識する。全部そのとおりです。ただ、これは当社の記事への指摘ではなく、世の中のすべての記事に当てはまる話でした。当社の決め事に触れた回答は、この2回では1つもありません。相手はそれを知らないからです。
出典:当社による実測(無料版ChatGPT・ログイン状態と一時チャットの2条件・各1回・2026年9月4日)。1回ずつの結果なので、傾向としては一般化できません。
ここが出発点です。多数派の画面は、その会社の事情を知らない画面でもあります。だから、返ってきた指摘をそのまま直すわけにはいきません。次の章から、実際の数字で見ていきます。
無料のChatGPTに本文を渡すと、何が返ってくるか
当社は記事を公開する前に、本文だけを渡して講評をもらいます。URLは渡しません。公開前で見せる場所がないうえ、URLを渡すと相手が本当にそのページを読んだのか分からなくなるからです。
2026年7月28日から9月13日までの12回とも、渡した相手は無料版のChatGPTです。有料版は使っていません。渡したものも毎回同じで、記事の本文HTMLと、その回に見てほしい観点だけです。
| 渡しているもの | 渡していないもの | そのぶん相手に見えないもの |
|---|---|---|
| 記事の本文HTML(見出し・本文・表・FAQ・図のコード) | ページのURL | 実際の表示(レイアウト・色・図の見え方) |
| その回に聞きたいこと(読みやすさ、構成、抜けなど) | ページの<head>の中身 | タイトルタグ・メタ説明・構造化データの一部 |
| — | サイト全体の記事一覧と役割分担 | ほかの記事との住み分け(同じ話を別の記事が担当していること) |
講評をもらうたびに、採否の理由をファイルに残してきました。今回この記事を書くにあたり、記憶や要約ではなくそのファイルを1本ずつ開いて数え直しています。数え方は「採否ファイルの1行=1件」で統一し、社内から出た指摘は含めていません。
| 何の記事か | 日付 | 指摘 | 採用 | うち「実装済み」 |
|---|---|---|---|---|
| AI活用ツールの解説 | 7月28日 | 7 | 1 | 5 |
| 社内定着の測り方 | 8月21日 | 13 | 6 | 3 |
| AIのモデルを入れ替えた実録 | 8月30日 | 13 | 3 | 6 |
| AIは動画を読むのか | 8月31日 | 4 | 1 | 3 |
| ノウハウ公開と模倣 | 9月3日 | 15 | 5 | 3 |
| AIに学習されたくない | 9月4日 | 11 | 5 | 3 |
| 社員が勝手に使う問題 | 9月5日 | 10 | 3 | 5 |
| 対策を外注すべきか | 9月7日 | 16 | 4 | 4 |
| AIを増やして壊れたもの | 9月8日 | 10 | 5 | 6 |
| 有料版に課金しているのは誰か | 9月10日 | 12 | 3 | 4 |
| 使いこなせない人の共通点 | 9月12日 | 7 | 0 | 7 |
| AIは画像をどう読むのか | 9月13日 | 7 | 1 | 3 |
| 合計(12回) | — | 125 | 37 | 52 |
出典:当社の採否ファイル12本を2026年9月13日に再集計。渡した相手は12回とも無料版のChatGPT、渡したものは本文HTMLのみ(2026年7月28日〜9月13日)。採用37件のほかに、保留・判定待ちが8件、不採用・対応不要が80件あります。
図1:指摘125件の内訳
いちばん多いのは、採用でも不採用でもなく「すでにやってあること」でした。2026年9月12日に公開した記事にいたっては、指摘7件が全部これで、採用はゼロです。
指摘の4割は「すでにできていたこと」でした
「すでに実装済み」と書くだけでは、こちらの言い分にすぎません。そこで同じ12本を、公開されているページから機械で数えました。目で見て数えたのではなく、ページのソースを取得して要素の個数を数えています。
| 何の記事か | 表 | FAQの構造化データ | 図(SVG) | 画像 |
|---|---|---|---|---|
| AI活用ツールの解説 | 8 | 19 | 0 | 14 |
| 社内定着の測り方 | 4 | 10 | 3 | 3 |
| AIのモデルを入れ替えた実録 | 7 | 8 | 1 | 4 |
| AIは動画を読むのか | 9 | 8 | 3 | 7 |
| ノウハウ公開と模倣 | 9 | 11 | 4 | 6 |
| AIに学習されたくない | 17 | 9 | 3 | 7 |
| 社員が勝手に使う問題 | 8 | 8 | 3 | 7 |
| 対策を外注すべきか | 7 | 8 | 2 | 3 |
| AIを増やして壊れたもの | 5 | 7 | 2 | 3 |
| 有料版に課金しているのは誰か | 7 | 8 | 2 | 3 |
| 使いこなせない人の共通点 | 10 | 9 | 2 | 4 |
| AIは画像をどう読むのか | 12 | 10 | 7 | 3 |
| 合計 | 103 | 115 | 32 | 64 |
出典:当社による実測(公開ページのソースを未ログインで取得して要素を機械カウント・2026年9月13日)。12本の本文は合計で約19万7千字です。
「表を入れましょう」と言われた12本には、すでに表が103本ありました。「FAQの構造化データを追加しましょう」と言われた12本には、すでに115問ぶん入っていました。図も32点、画像も64枚あります。
では、なぜ相手には無いように見えるのか。渡し方のせいです。表もFAQも図も構造化データも、文章として読み上げたときには出てきません。本文のテキストだけを読むと、そこには「見出しと段落」しか無いように見えます。
図2:渡している範囲と、相手から見えていない範囲
つまりこの52件は、相手が手を抜いた結果ではありません。本文だけを渡すと決めている以上、必ずこの種類の指摘が出ます。出ることを前提にして、採否で落とすのが正しい扱い方です。
ここから後半です。残りは4つだけです。①外部の目が本当に効いた6件 ②確かめる側が間違えた2件 ③当社の採否の手順 ④明日からできる3つ。お急ぎでしたら、③の手順だけでも役に立つはずです。
それでも外部の目が要る理由は、6件にあります
ここまでの数字だけを見ると「無料のAIに見せても意味がない」と読めてしまいますが、そうではありません。6件は、こちらが見落としていた本物の誤りでした。しかも6件とも、同じ性質の誤りです。
| 日付 | 何を指摘されたか | どう直したか |
|---|---|---|
| 8月21日 | 「15日以上で定着」の目安に、公的な根拠があるように読める | 「公的な基準ではなく、当社が実務で置いている目安です」と注記を追加 |
| 8月30日 | 見出し「誤りの率は変わらなかった」が一般論に見える | 「今回の4期間では大きな差は出なかった」に変更 |
| 9月4日 | 「1行書くだけ」は不正確 | 実際は1社につき2行×社数なので「AI各社ごとに2行ずつ」に変更 |
| 9月5日 | 「決め事を残したから良くなった」は効果の証明ではない | 「観察した結果であって、因果を測ったわけではありません」と明記 |
| 9月10日 | 「どのサービスでも有料でないと使えない」は全部を測っていない | 「主要な生成AIサービスでは有料プラン側に置かれています」に変更(4か所) |
| 9月13日 | 「確実に受け取っているのは説明文」は断定が強すぎる | 主語を移して「こちらから確実に渡せるのは説明文だけ」に変更(5か所) |
出典:当社の採否ファイル6本(2026年8月21日〜9月13日)。いずれも指摘を受けてから当日〜翌日に修正しています。
6件とも、事実そのものは間違っていません。数字も出典も合っています。強すぎたのは「言い方」のほうです。そして言い方の強さは、書いた本人にはいちばん見えません。自分では「そう思って書いている」からです。
いちばん重かったのは、9月13日の1件です。画像の説明文(alt)について「機械が確実に受け取っているのは説明文のほうだ」と書いていたのですが、同じ記事の第1章で、自分が引用していた公式の説明と食い違っていました。公式は「説明文と画像認識とページの内容の3つを合わせて判断する」と書いており、こちらの書き方はそのうちの画像認識を否定するように読めたのです。
| 直す前 | 直した後 |
|---|---|
| 機械が確実に受け取っているのは、画像そのものではなく説明文のほうです | 機械へ、こちらから文字で確実に渡せるのは、画像そのものではなく説明文だけです |
| 主語=相手(機械)の動作。相手の中で起きることなので、こちらは断定できません | 主語=自分の動作。自分がやっていることなので、事実として書けます |
6件が全部同じ型だった、というのが今回いちばんの発見でした。多数派の画面が拾ってくれるのは「足りないもの」ではなく「強すぎるもの」だ、ということです。足りないものはこちらが数えれば分かります。強すぎる言い方は、数えても出てきません。
逆にいえば、確かめる側に「足りないものを教えてください」と期待するのは、使い方として少しずれています。頼むべきは「言いすぎているところはありませんか」のほうです。当社は講評を頼むときの聞き方も、この6件のあとで変えました。
断定を弱めると記事が弱くなる、とは限りません。上の例では、主語を相手からこちらに移しただけで、主張の強さは落ちずに、事実としての正しさだけが上がりました。
確かめる側が間違えた2件も、同じ重さで書きます
都合のよい結果だけ載せるわけにはいかないので、逆の話も書きます。確かめる側が間違えたことも2回ありました。どちらも同じ型で、記事の外にあるものを、記事の中身だと思って指摘してきたケースです。
| 日付 | 何が起きたか | どう扱ったか |
|---|---|---|
| 9月3日 | 記事の下に自動で出る別の記事の案内を、この記事の案内として「直すべき」と指摘してきた | 記事のソースを検索したところ、その文言は本文に1件も無し。記事側の修正はなし |
| 9月7日 | 記事の下に自動で並ぶ関連記事の見出しを、この記事の主張として指摘してきた | 同じく本文に0件。ただし「同じ画面に別の主張が出ている」という指摘自体は正しいので、別の課題として起票 |
出典:当社の採否ファイル2本(2026年9月3日・9月7日)。どちらも記事のソースを取得して、本文中の出現回数が0件であることを確認しています。
この2件から、運用をひとつ足しました。指摘に出てくる言葉が、本当に本文の中にあるかを先に確かめることです。本文に無い言葉を褒めたり直せと言ったりしている場合、相手は別のものを見ています。
この型は、AIに限った話ではありません。人に読んでもらうときも、記事の下に並ぶ広告や関連記事まで含めて「この記事」として受け取られます。LLMO・AIO・GEO対策では、ここがとくに効きます。本文をどれだけ正確に書いても、同じ画面に古い見出しが並んでいれば、AIも人もそれを一緒に読むからです。
採否の手順(当社がやっている5つ)
図3:当社の採否の手順
①実物を数える/②言葉を照合する
講評を読むより先に、自分の記事に何がいくつ入っているかを数えます。表の数、FAQの数、図の数、画像の数。ここまでやると、指摘の半分近くは「すでにある」で片づきます。次に、指摘に出てくる固有の言葉が本文にあるかを検索します。本文に無い言葉を褒めていたら、相手は別のものを見ています。
③残った指摘を、3つに仕分ける
| 分類 | 見分け方 | 扱い |
|---|---|---|
| 言い切りすぎ | 事実は合っているが、断定や一般化が強い | 直す。いちばん価値のある指摘です |
| 実装漏れ | 本当に入っていない(数えて確認できる) | 直す。ただし数えるまで判断しません |
| 土俵違い | ほかの記事が担当している話、読者が違う話 | 直さない。取り入れると記事どうしが食い合います |
3つ目の「土俵違い」は見落としやすいところです。確かめる側はサイト全体の役割分担を知らないので、よかれと思って、別の記事の担当範囲を足してきます。取り入れると、自社の記事どうしが同じ言葉で競合します。LLMO・AIO・GEO対策では、これがいちばんもったいない失敗です。
④測定中かどうかを見る/⑤理由つきで記録する
当社は記事を公開したあと、28日間はタイトルと本文の言い回しを動かさずに反応を測ります。採用に値する指摘でも、測定中なら測り終わってから直します。先に直すと、順位や検索での出方が変わったときに、記事の中身が効いたのか直したことが効いたのかを切り分けられなくなるからです。ただし事実が違っている場合は、測定を理由に待ちません。間違ったまま測っても意味がないからです。
最後に、採否と理由をファイルに残します。この記事の125件という数字も、その記録があったから数え直せました。記録が無ければ、「外部の目は役に立った気がする」で終わっていたはずです。
自分の会社でやるなら、明日からの3つ
| やること | なぜ | かかる手間 |
|---|---|---|
| ①道具を役割で分ける(作る=性能/確かめる=利用者の多さ) | 基準が違うものを同じ物差しで選ぶと、どちらかが必ず外れます | 1回決めるだけ |
| ②渡すものを先に決める(本文だけか、画面ごとか) | 渡していないものは「無い」と言われます。先に決めれば、その指摘を落とせます | 1回決めるだけ |
| ③指摘を3つに仕分ける(言い切りすぎ・実装漏れ・土俵違い) | 全部直すと、すでにあるものを二重に足すか、狙いを壊します | 指摘1件あたり数十秒 |
そのうえで、確認そのものを分けて考えると、もっと楽になります。機械が数えられることは機械に、判断が要ることは人に。当社はこう分けています。
| 確認の中身 | 誰がやるか | 理由 |
|---|---|---|
| 表・FAQ・図・画像の数、リンクが生きているか、表記のゆれ | 機械(数える) | 数えれば白黒がつく。人がやると見落とします |
| 言い切りが強すぎないか、読み手が誤解しないか | 無料のChatGPT+人 | 書いた本人にはいちばん見えない部分です |
| 数字の出どころ、いつの数字か、どこまで言えるか | 人(必須) | 確かめる側は事実の正しさを見ていません |
| ほかの記事と食い合っていないか | 人 | サイト全体の役割分担は、外からは見えません |
当社の場合、この分け方を決めてから、講評をもらってから公開するまでの時間がむしろ短くなりました。指摘の半分近くを、数えるだけで落とせるようになったからです。
もうひとつ、社長の立場で申し上げておきたいことがあります。AIに確かめさせても、責任は分かれません。確かめる側は、その会社の決め事も、過去に何を書いたかも、どの数字をどこから取ってきたかも知りません。最後に「これで出す」と決めるのは、やはり人です。この記事の6件も、直すと決めたのは人でした。
LLMO・AIO・GEO対策を、どこから手をつけるか迷っていたら
当社は自社サイトで、この分け方を実際に回しています。御社の記事づくりのどこに人の確認を置くか、60分でご一緒に整理します。売り込みはいたしません。
※ ITコーディネータ・酒井大輔が対応します。
次に読む
よくある質問(FAQ)
QLLMO・AIO・GEO対策の記事は、有料のAIで作らないとだめですか+
Q確かめるのも、有料版のほうがいいのではないですか+
QなぜChatGPTなのですか+
Q指摘は全部直したほうがいいですか+
Qなぜ「すでにできていること」を指摘されるのですか+
Q確かめる側は、書いてある事実が正しいかまで見てくれますか+
Q指摘を直すのは、公開の前ですか後ですか+
Q自分で読み返すのと、何が違いますか+
まとめ
- LLMO・AIO・GEO対策の記事づくりでは、作る道具と確かめる道具を、別の基準で選びます。
- 作る側=性能で選ぶ。目的は結果なので、当社はClaudeの上位プラン(月200ドル・税抜)1本にしています。
- 確かめる側=利用者の多さで選ぶ。国内の利用率首位はChatGPT(30.6%)。安いからではなく、多数派が見ている画面だから無料版を使います。
- 12回とも無料版のChatGPTに渡し、指摘125件を数え直すと、52件(約4割)は「すでに実装済み」でした。表は103本、FAQの構造化データは115問すでに入っていました。
- 本当に直したのは6件。6件とも「言い切りが強すぎる」という同じ型で、どれも自分では気づけませんでした。
- 確かめる側が、記事の外にあるものを中身として指摘してきたことも2回。指摘は元のデータで裏を取ってから採否を決めます。
- AIに確かめさせても、責任は分かれません。最後に出すと決めるのは人です。