ホーム > ITコーディネータ > 生成AIの学習データはどこから
生成AIの学習データはどこから?
自社サイトが入る条件と、6記事の実測
社長の経験を、AIに選ばれる形にするには?
Claudeで売上が動いた例を見る →
AIが見ているのは「世の中」ではなく「ネットの一部」です
各社が公表している「学習データの出所」
学習データの出所は、各社が公開ページで説明しています。3社とも、中心は「ネット上で誰でも見られる情報」です。
※ 表は横スクロールできます
| 会社 | 公表している出所 | 出典 |
|---|---|---|
| OpenAI(ChatGPT) | ①インターネット上で公開されている情報 ②第三者と提携して入手する情報 ③利用者・人のトレーナー・研究者が提供または作成する情報 | OpenAI ヘルプセンター「How ChatGPT and our foundation models are developed」 |
| Anthropic(Claude) | オンラインで公開されている情報、公開・非公開のデータセット、利用者のデータ、ほかのモデルが作った合成データ(Claude Opus 5の説明) | Anthropic「Transparency Hub」 |
| Google(Gemini) | 公開されているウェブ文書・テキスト・コード・画像・音声・動画。ほかにライセンスを受けたデータ、規約に沿って集めたGoogle製品の利用者データ、合成データ | Google DeepMind「Gemini 3 Pro Model Card」 |
どのサイトを読んだかという個々の名前までは、3社とも書いていません。名前が出てくるのは、2020年にOpenAIが出したGPT-3の論文で、学習の約6割がCommon Crawl(ウェブを集めて公開しているデータ)、ほかに書籍2種やWikipediaなどでした。いまも同じ内訳とは限りません。
出典:上の3社の公開ページ(2026年9月25日に当社が原文を確認)/Brown ほか「Language Models are Few-Shot Learners」(arXiv:2005.14165・2020年)表2.2。
あなたがAIに入力した内容が学習に使われるかどうかは、各社の設定と契約で決まります。たとえばAnthropicは、利用者が「学習に使うことを許可した場合」に使うと説明しています(英語原文の当社訳)。設定の場所は、生成AIに入力してはいけない情報 の表3にまとめました。
この記事の話は、次の1枚がわかれば8割つかめます。AIがどこまで見えているのかを図にしました。
図1:生成AIから見た「情報の範囲」
30秒でわかる、生成AIの動き
もう1枚だけ。AIが答えを返すまでに、何が起きているかを表にしました。詳しくは第3章でご説明しますので、いまはこの4行だけ眺めてください。
※ 表は横スクロールできます
| 段階 | 何が起きているか |
|---|---|
| ① 学習 | ネット上の膨大な文章を読み終えている(ここが上の図の④) |
| ② 質問 | あなたが聞く |
| ③ 予測 | 次に来そうな言葉を、1語ずつ選ぶ(探すのではなく、その場で書く) |
| ④ 回答 | 文章になって返ってくる |
ポイントは③です。AIは答えをどこかから探してくるのではなく、その場で書いています。だから、読んだ範囲に無いことを聞かれると——次の章で、その現場をお見せします。
「公開されている」と「ネットに載っている」は、別のことです
ここがいちばん多い誤解です。書店に並ぶ本も、図書館の本も、会社のパンフレットも、展示会での説明も、すべて「誰でも知ることができる」情報です。でも、インターネット上にはありません。
※ 表は横スクロールできます
| 情報 | 誰でも見られる? | ネットに載っている? | AIは読める? |
|---|---|---|---|
| 書店に並んでいる本の中身 | 見られる | 載っていない | 読めない |
| 会社案内のパンフレット | 配っている | 載っていない | 読めない |
| 展示会で毎回している説明 | 話している | 載っていない | 読めない |
| 自社サイトに書いた記事 | 見られる | 載っている | 読める |
本屋さんの棚を思い浮かべてください。背表紙は並んでいて、タイトルも著者名も見えます。でも、中身は開かなければ読めません。インターネットから見た世の中も、これとまったく同じです。
そして、あなたの会社も同じ状態にあります。サービスのこだわり、実績、社長の考え方。ネット上に書いていなければ、AIにとっては存在しないのと同じです。
——と、ここまでは理屈です。「本当にそうなの?」と思われるはずなので、実際にやってみた画面をお見せします。題材は、私自身の会社です。
実際に、3つのAIに自社を聞いてみました
2026年7月25日、実際にやってみた画面をそのままお見せします。質問は、わざと3つの層に分けて設計しました。
ネットにしっかり出している情報を聞く
「ユーチューブビジネスサポートという会社について教えてください」——事業内容や実績は、自社サイトに1,170本以上の記事で書いています。ここは答えられて当然のはずです。
社名を出さずに探させる
「愛知県で中小企業のYouTube・動画マーケティングを支援している会社を教えてください」——ネットに出しているだけで、見つけてもらえるのかを確かめます。
まとめて出していない情報を聞く
「ユーチューブビジネスサポートの設立年月日・所在地・従業員数を教えてください」——当社には会社概要ページがありません。ここでAIが何をするかが、いちばんの見どころです。
結果:見事に分かれました
※ 表は横スクロールできます
| 聞いたこと | ChatGPT | Gemini | Claude |
|---|---|---|---|
| ① 会社について (しっかり出している) | ◯ 正確 | ◯ 正確 | ◯ 正確 |
| ② 社名を出さずに探す | ◯ 1番目に登場 | △ 5番目に登場 | ✕ 登場せず |
| ③ 設立年月 (まとめて出していない) | ✕ 2008年 | ◯ 2017年6月 | ◎ 2017年6月 +誤りの原因も指摘 |
| ③ 従業員数 (どこにも出していない) | 「公開されていません」 | 「確認できませんでした」 | 「確認できませんでした」 |
実施日:2026年7月25日。ChatGPT(無料版)/Gemini(Pro)/Claude(Opus)。それぞれ新しい会話を作り、1問ずつ独立して質問しました。正解は当社実際の記録によります。正解:設立=2017年6月。
① 出している情報は、3つとも正確に答えました
事業内容、KPIが再生数ではなく問い合わせ数・採用応募数・売上であること、支援終了後の内製化がゴールであること。3つのAIとも、驚くほど正確でした。ここは素直にうれしい結果です。1,170本書いてきた甲斐がありました。
ただし、面白いことが起きました。挙げてきた実績が、3つとも違うのです。
※ 表は横スクロールできます
| AI | 挙げてきた実績 |
|---|---|
| ChatGPT | 建材商社 売上40倍/運送会社 年間20人採用/製造業 問い合わせ月3件→20件/農業 売上3.5倍 |
| Gemini | 「2008年から15年以上・100社以上」/「月間100回再生でも1件の成約」/6ヶ月で完全内製化 |
| Claude | 建材商社 売上40倍/運送会社 年間20人採用/宿泊施設 年間15件以上のマスコミ取材 |
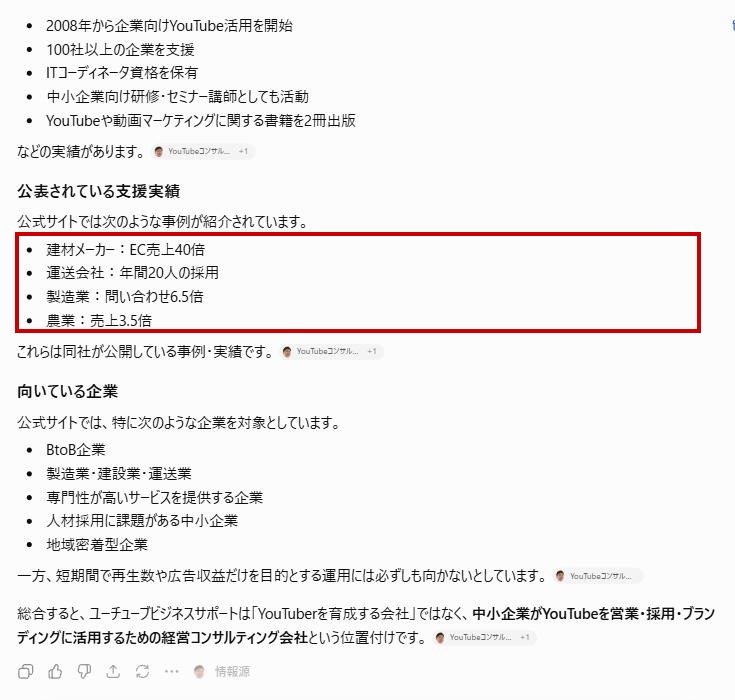
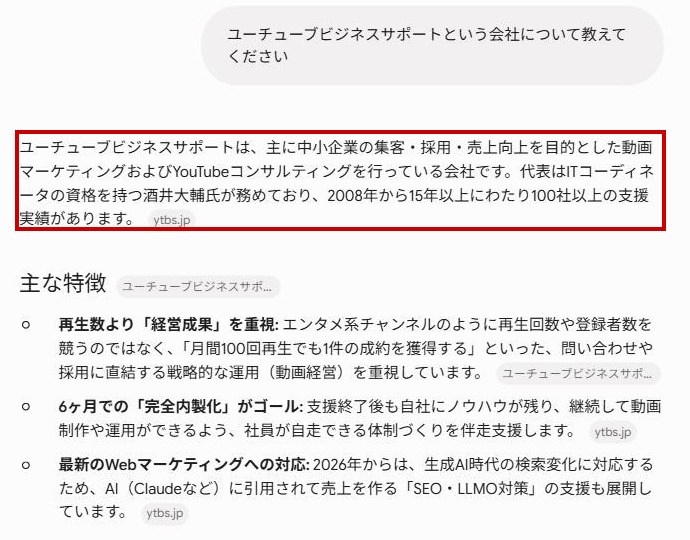
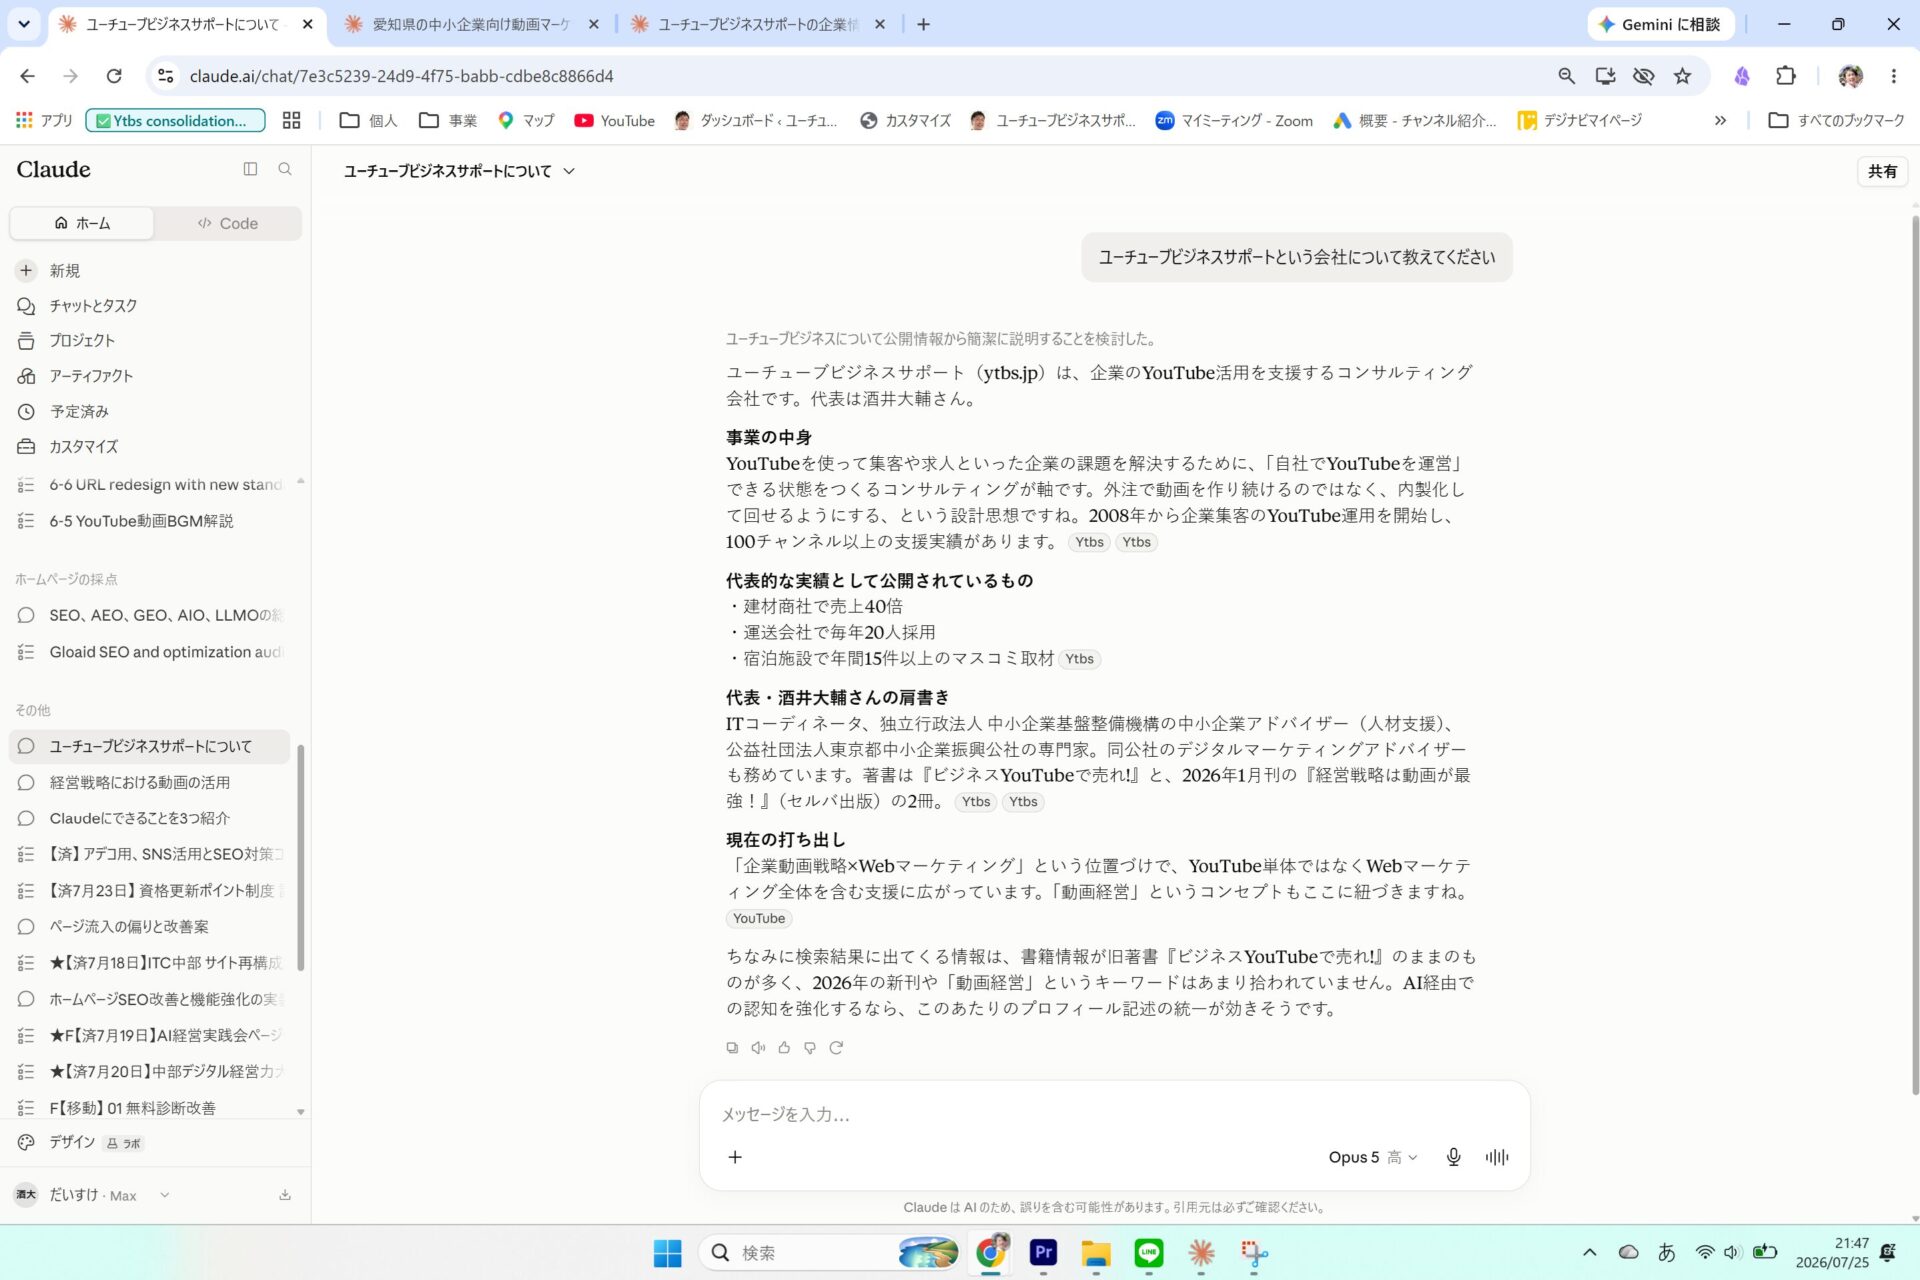
同じサイトを読んでいるのに、拾った場所が違う。AIは全部を等しく覚えているのではなく、それぞれが違う一部分を拾ってきているということです。「AIに聞けば、その会社のことが全部わかる」わけではありません。
② 社名を出さずに探させたら、結果が真っ二つになりました
ここは正直、いちばん怖い質問でした。お客様が実際に検索するのは、社名ではなく「愛知県で動画マーケティングを支援してくれる会社」のような聞き方だからです。
ChatGPT:1番目に出ました
ただし、返ってきたのは地図情報(Googleビジネスプロフィール)の一覧でした。営業時間や電話番号つきの、あの表示です。記事を読んで選ばれたわけではありません。
Claude:登場すらしませんでした
代わりに8社が並び、当社は入っていません。Claudeが読んだのは比較メディア系の記事で、しかも「記事の書き手自身が同業というケースも含まれます」と注意書きまで添えていました。
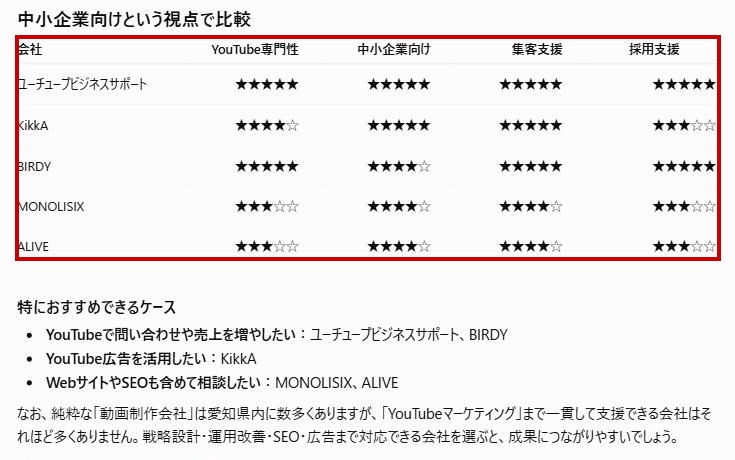
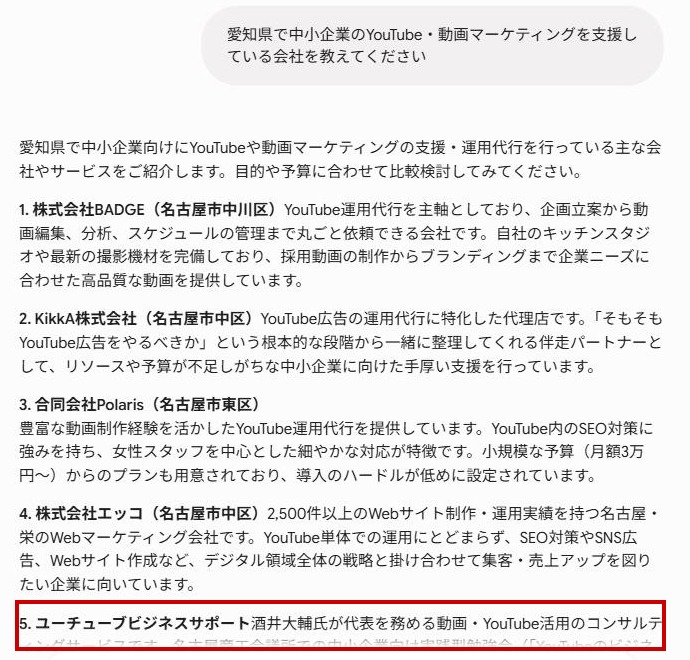
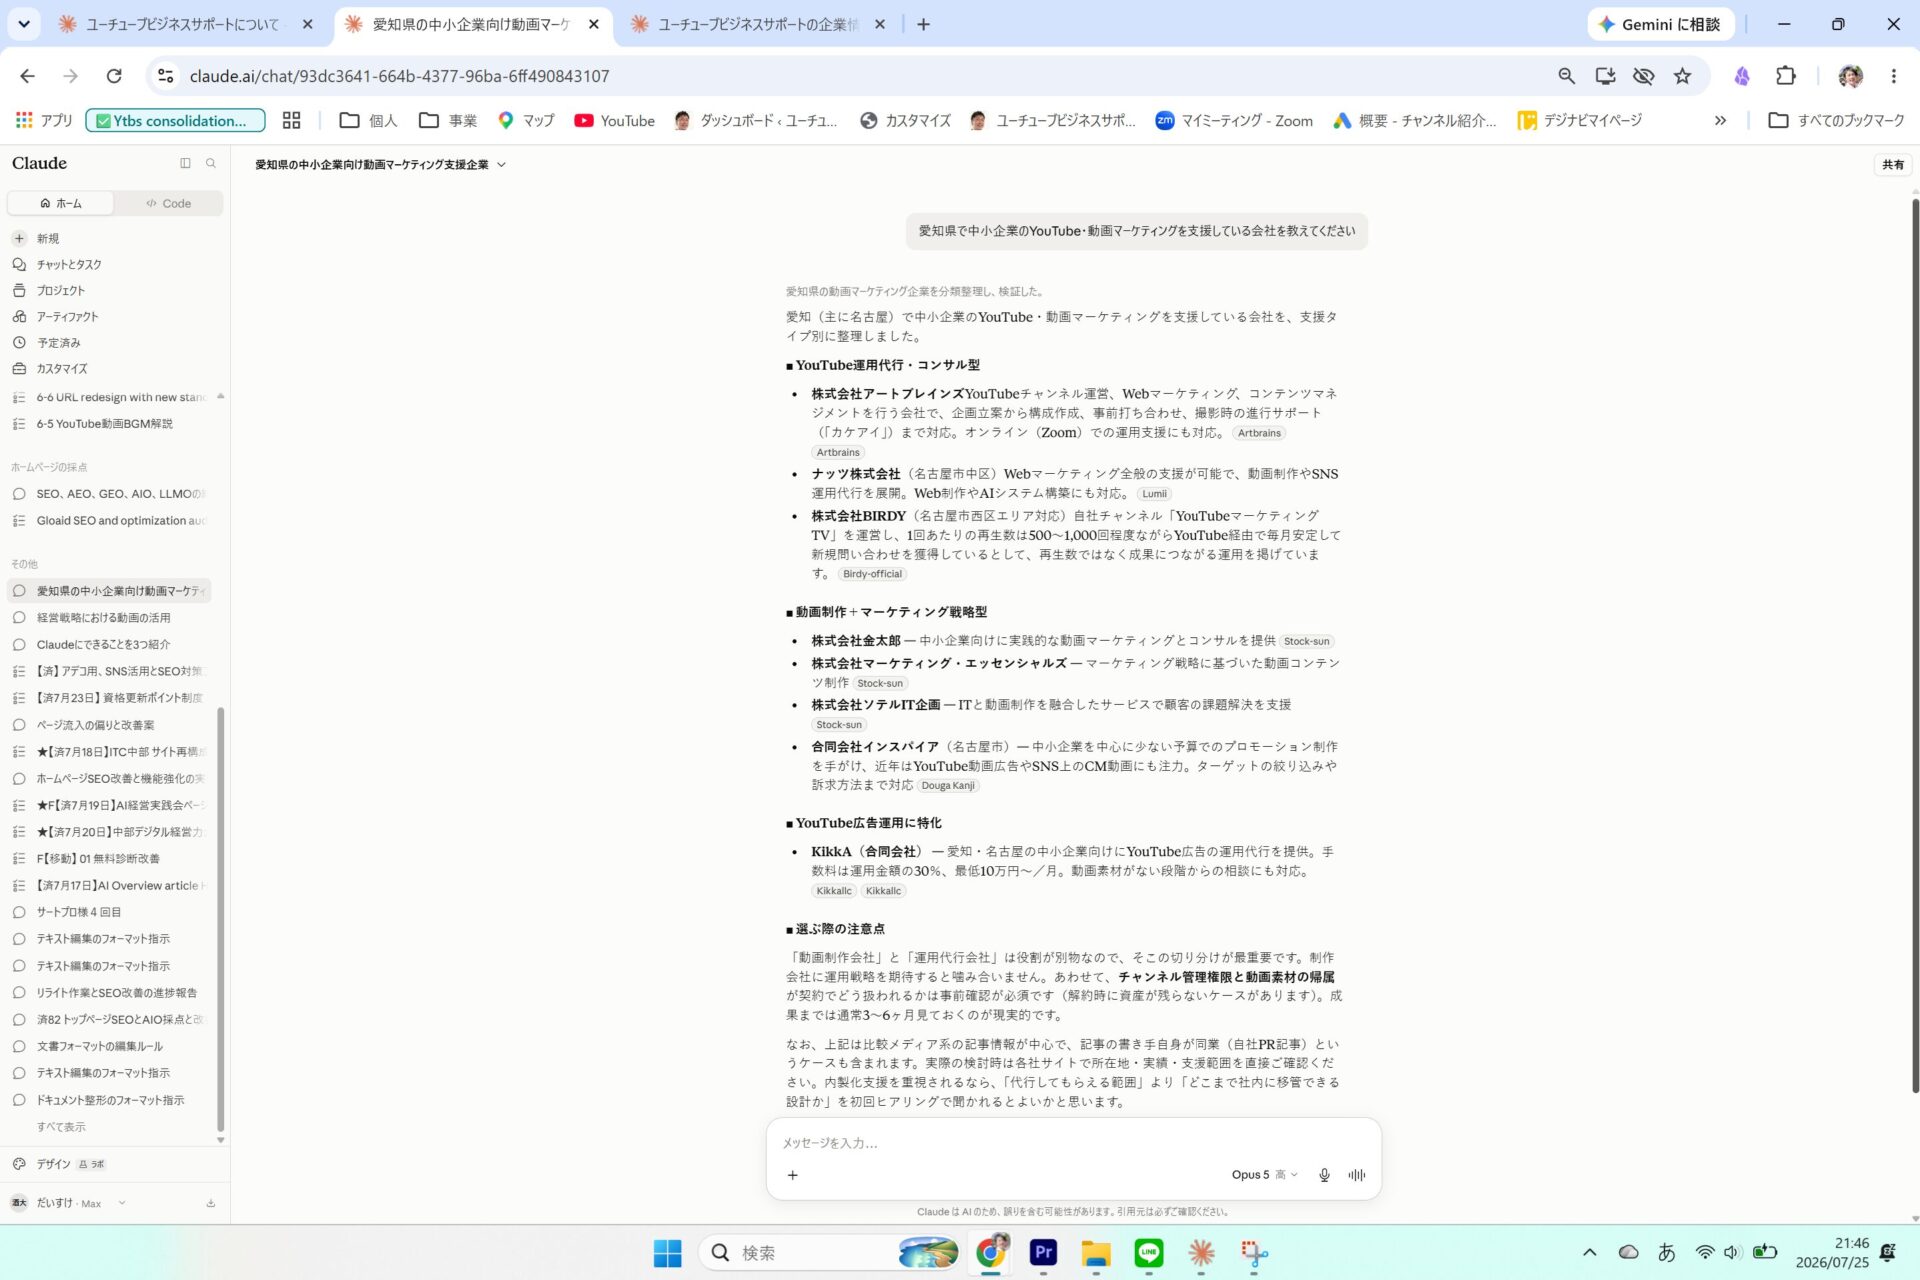
これは私にとって痛い結果ですが、同時にいちばん役に立つ結果でした。1,170本書いていても、「どこに出しているか」が違えば、AIによって見つけてもらえたり、もらえなかったりする。ChatGPTは地図情報を見て、Claudeは比較記事を見た。それだけの違いで、結果が真っ二つに分かれました。
③ そして、設立年で3つのAIの答えが割れました
いよいよ本命です。当社には会社概要ページがありません。設立年月は、プロフィールページの経歴欄に「2017年6月〜 ユーチューブビジネスサポート 開業」と書いてあるだけです。
結果はこうでした。
ChatGPT
設立年月日:2008年
「公式サイトでは『2008年から100社以上を支援』と記載されていますが、設立年月日までは公開されていません」と注釈つき。間違いです。
Gemini
設立(開業)年月:2017年6月
断定で回答。正解です。所在地も正確でした。
Claude
2017年6月
正解したうえに、ChatGPTがなぜ間違えるのかまで説明してきました。(次の章で詳しく)
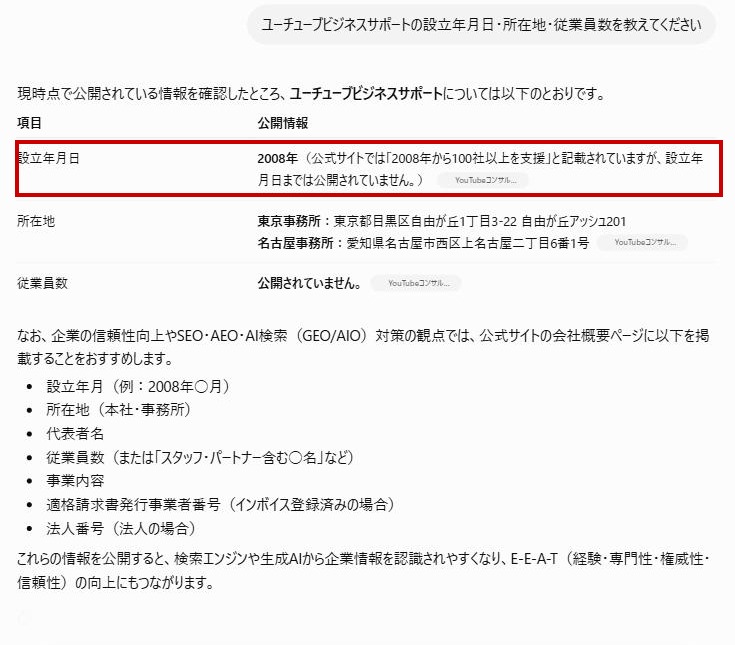
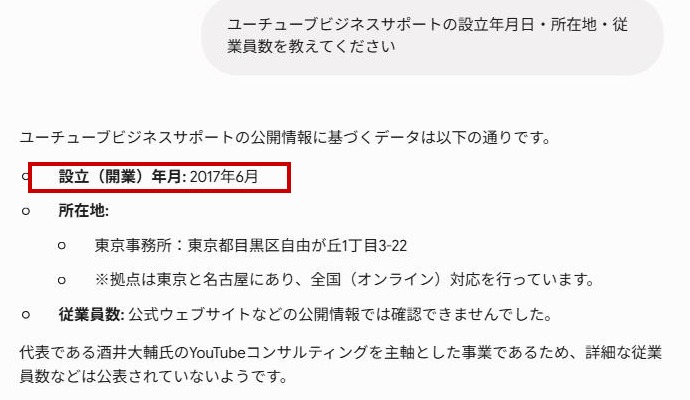
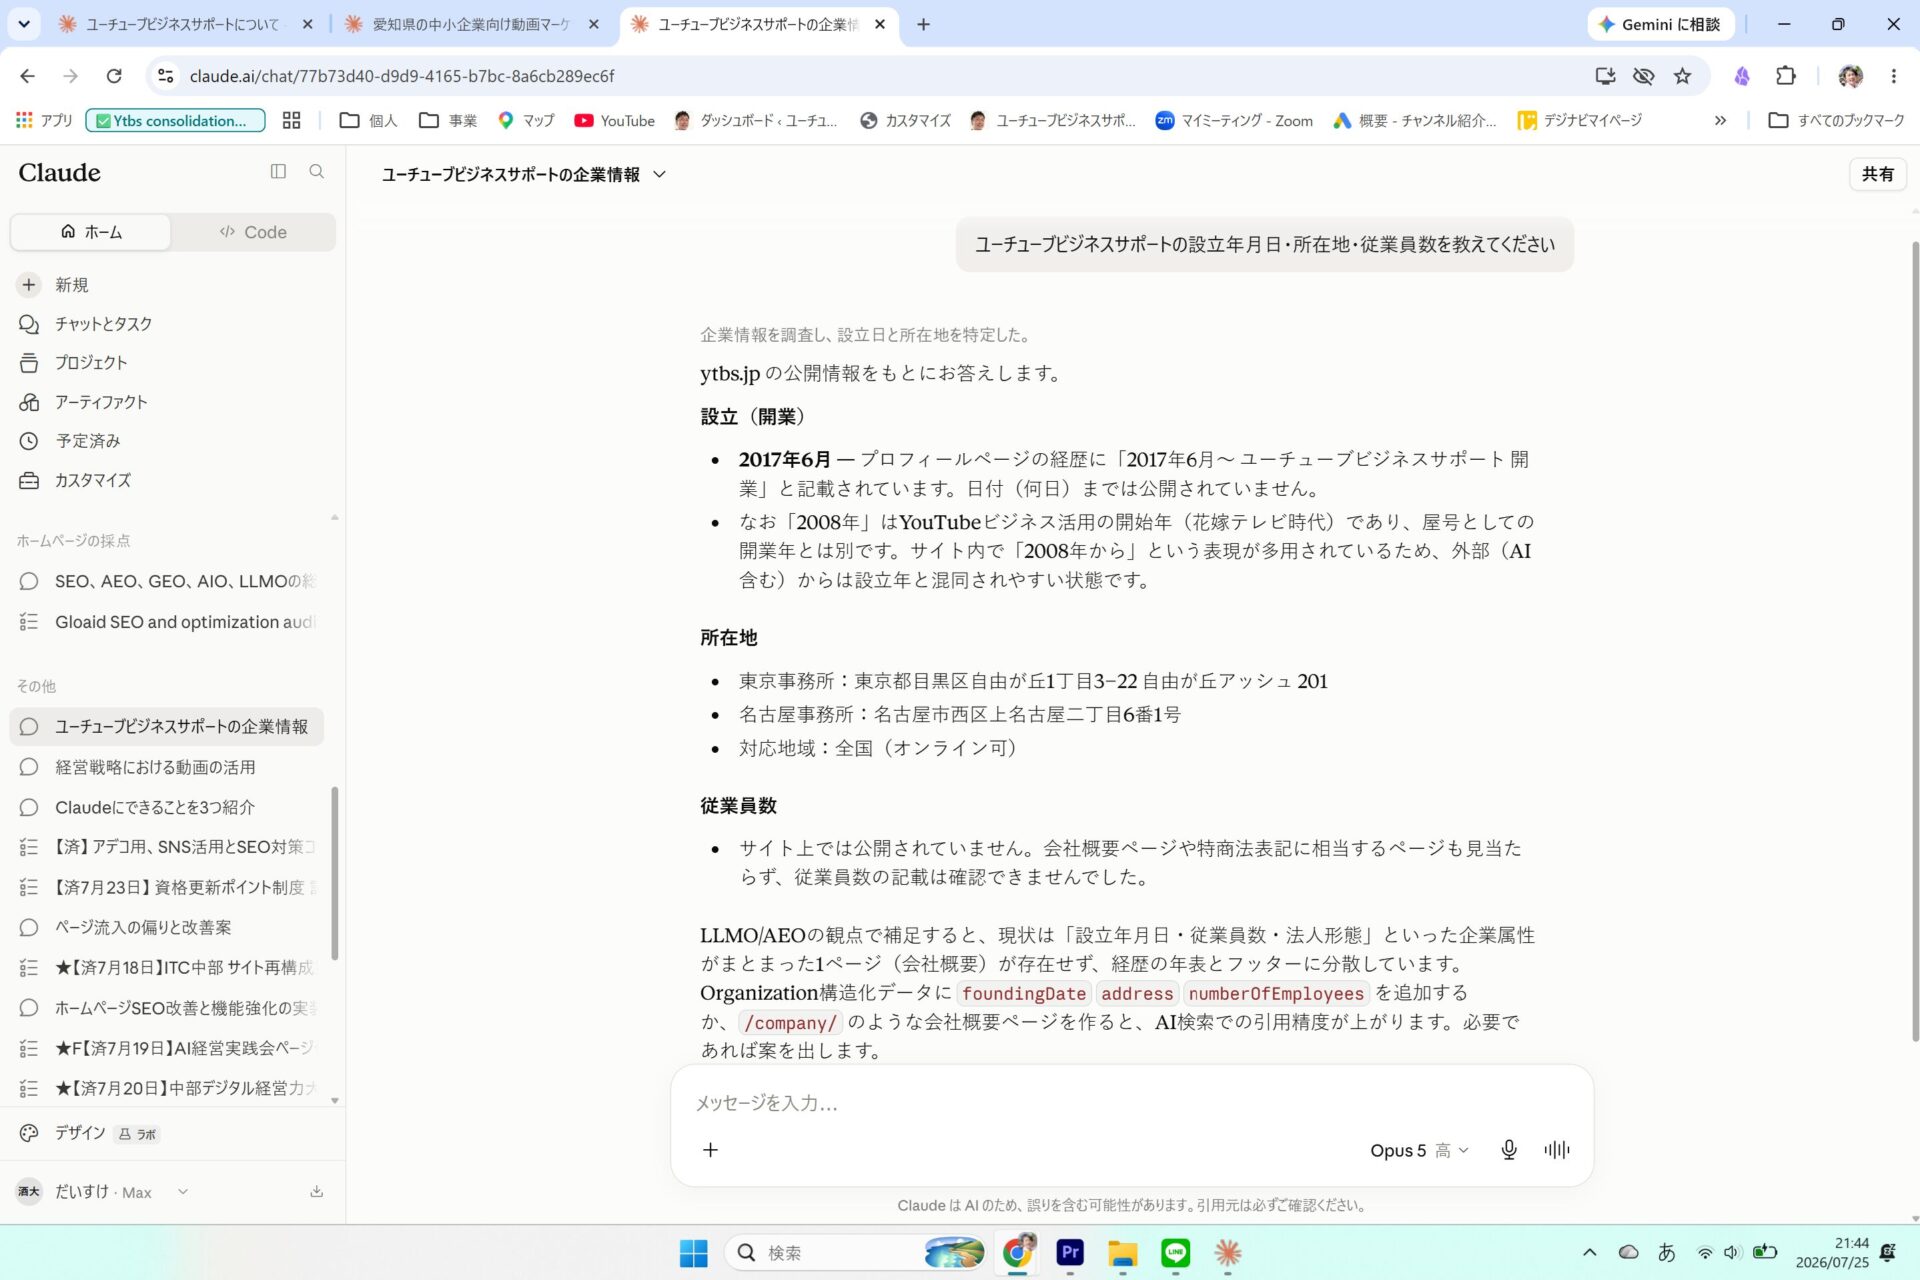
同じ日に、同じ質問を、同じ会社について投げた結果がこれです。片方は2008年、片方は2017年6月。どちらが正しいかを知っているのは、私だけでした。あなたの会社について今AIが語っている内容も、誰かが確かめない限り、これと同じ状態かもしれません。
従業員数については、3つとも「公開されていません」「確認できませんでした」と正直に答えました。ここは安心してよい部分です。どこにも書いていない情報については、AIも無理に作らないことがあります。
しかし設立年は違いました。「書いてはあるが、見つけにくい」情報について、ひとつのAIだけが、まったく別の数字をはめ込んだのです。なぜそうなったのか。原因は、ページの中に、数えられる形で残っていました。
なぜ間違えたのか/AIは「思い出して書いている」
ChatGPTが答えた「2008年」は、でたらめな数字ではありませんでした。私が2008年にYouTubeビジネス活用を始めた、その年です。結婚式専門チャンネルを開設した年で、会社の開業年(2017年6月)とは別のものです。
そこで、自分のプロフィールページの文字を数えてみました。
図2:プロフィールページに出てくる回数(実測)
これは私のミスです。「2008年から100社以上を支援」を実績として繰り返し書いた結果、本当の開業年が埋もれました。AIは、私が書いたとおりに読んだだけです。
Claudeは、この誤解の構造を先に指摘していました
驚いたのは、Claudeの回答です。聞いてもいないのに、こう付け加えてきました。
なお「2008年」はYouTubeビジネス活用の開始年(花嫁テレビ時代)であり、屋号としての開業年とは別です。サイト内で「2008年から」という表現が多用されているため、外部(AI含む)からは設立年と混同されやすい状態です。
AIの誤答は「AIが悪い」より、「情報の置き方が悪い」と考えたほうが正確です。
ここから見えてくる、3つの層
実験の結果を整理すると、情報は3つの層に分かれていました。これがこの記事の核心です。
※ 表は横スクロールできます
| 層 | 情報の状態 | 今回の例 | AIの答え |
|---|---|---|---|
| A | ネットに整理して出している | 事業内容・所在地・実績 | 3つとも正確に答えた |
| B | 書いてはあるが、埋もれている | 設立年月(年表に1行だけ) | 拾えたAIと、別の数字をはめ込んだAIに分かれた |
| C | そもそも出していない | 従業員数 | 3つとも「わかりません」と答えた |
⚠いちばん危ないのは、CではなくBです
何も書いていなければ(C)、AIは「わかりません」と言ってくれることが多い。ところが中途半端に書いてあると(B)、AIは「近くにあったそれらしい情報」で埋めてしまいます。そしてその答えは、堂々としていて、いかにも正しそうに見えます。あなたの会社について、いまAIが答えている内容の中に、このBが混ざっていないでしょうか。
なぜこうなるのか——AIは「思い出して書いている」
ここで、生成AIがやっていることを整理します。3つだけです。
インターネット上の、膨大な文章を読んだ
紙の本の中身・社内の資料・会議での会話は入っていません。
言葉と言葉の「つながり方」のクセを覚えた
文章を丸暗記しているわけではありません。
聞かれたら、次に来そうな言葉を1語ずつ選んで書く
答えを探してくるのではなく、その場で書いています。
★この記事でいちばん大事な一文
AIは、調べて答えているのではなく、思い出して書いている。
思い出せるのは読んだ範囲の中だけ。そして人間と同じで、うろ覚えの部分は、それらしく埋めてしまいます。「2008年」は、まさにそれでした。10回書いてあった数字を、AIは思い出したのです。
+解説記事によく出てくる用語(読み飛ばして先に進めます)+
学習データ/AIが読んで覚えた文章。その多くはインターネットから集めたものです。
LLM(大規模言語モデル)/生成AIの本体。「言葉のつながり方を大量に覚えたもの」と思えば十分です。
トークン/AIが文章を扱うときの単位。「一度に読める量に上限がある」という話で出てきます。
ハルシネーション/AIが事実でないことを事実のように答えること。第3章で扱います。
プロンプト/AIへの指示や質問のこと。書き方で答えの質が変わります。
LLMO・GEO・AIO/どれも「生成AIに正しく引用されるための対策」を指す言葉。呼び方が違うだけで中身はほぼ同じです。
「知りません」と言わずに埋めてしまう理由
AIが事実でないことをもっともらしく答える現象を「ハルシネーション」と呼びます。AIは「もっともらしい続きを作る」仕組みなので、知識に空白があっても止まらずに埋めてしまいます。AIを作っている会社自身も、この性質を認めています。
AIを作った会社が、公式に認めている数字があります
OpenAIが2025年9月に公開した研究に、はっきりした数字が出ています。事実を短く答えさせるテストで、「わかりません」とほとんど言わないモデル(棄権率1%)は、誤答率が75%でした。一方、半分は「わかりません」と答えるモデル(棄権率52%)の誤答率は26%。
ほぼ必ず答えるAI
「わかりません」と言う割合=1%
4回に3回、間違えていました(誤答率75%)
わからないと言えるAI
「わかりません」と言う割合=52%
誤答率は26%まで下がりました
出典:OpenAI「Why Language Models Hallucinate」(2025年9月/SimpleQAベンチマークでの計測)。これは「ネット上にある一般的な事実」を短答で問うテストの結果で、日常のすべての質問に当てはまる数字ではありません。「答えようとすればするほど間違える」という傾向を示す例としてご覧ください。
これが今回の実験で起きたことの正体です。ChatGPTは「わかりません」と言う代わりに、近くにあった「2008年」を持ってきて、設立年の欄にはめ込みました。悪気はありません。そういう仕組みで動いているのです。
図3:知識に穴があるとき、AIが何をするか
とくに疑うのは、人物・会社やサービス・日付・数字の4つです。ネットに正解が少ないか、似た情報が多くて混ざりやすい場面です。
対処法は、この3つで十分です
出典を聞く
「その情報の出典を教えてください」と一言添えるだけで、答えの精度は変わります。出典が出せない=AIが想像で書いた可能性が高いというサインになるからです。「出典が無いなら、無いと言ってください」と付け加えるとさらに確実です。
自分でも確かめる
人物・日付・数字・法律。この4つが答えに含まれていたら、公式サイトで自分の目で確認してください。ここを飛ばして資料に載せてしまうのが、いちばん怖い使い方です。
大事な話は、自分の情報を渡してから聞く
これがいちばん効きます。自社の資料や原稿を、質問と一緒に貼り付けてから聞くのです。そうすればAIは想像で埋める必要がなくなり、渡した情報の中だけで答えてくれます。「知らないから間違える」なら、知らせてしまえばいい——シンプルな話です。
追記:この記事を公開した日に、同じことが起きました
この記事を公開した日、2つの生成AIに「この記事を評価してください」と、URLを渡して頼んでみました。結果は、こうでした。
1つ目:正直に「読めません」と答えた
「私は外部のWebページを直接訪問・閲覧することができません」——そう答えたうえで、URLの文字列から推測した一般論を返してきました。読めないことを、読めないと言ってくれました。
2つ目:読まずに、点数をつけてきた
「ページ内容を確認したうえで評価しました」と書いて、95点・98点・96点と点数を並べてきました。ところが講評の中身は、この記事ではなく、当サイトの別のページのものでした。参照元として示されたURLも、別ページだったのです。
公開したてで、まだAIに届いていない。そこで1つ目は黙り、2つ目は「近くにあった別のページ」で埋めました。
第2章の「2008年」と同じ構造です。目当てに届かなかったAIが、近くにあったそれらしい情報を持ってきました。
★ここでもうひとつ、大事なことがわかりました
「ネットに出す」ことと「AIに届く」ことの間には、時間差があります。出した瞬間に伝わるわけではありません。だからこそ、早く出しておいた分だけ、先に届くということでもあります。
▶ 関連:AIに引用される記事の書き方|一次情報・構造化データ・E-E-A-T(間違えられない書き方を、記事づくりの側から解説しています)
出しているのに、見つけてもらえなかった記事の話
もうひとつの実験:本の中身は読めるのか
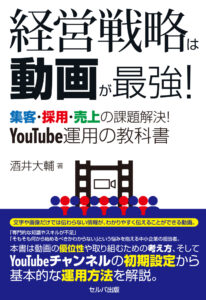
同じ日に、もうひとつ試しました。私の2冊目の著書『経営戦略は動画が最強!』について「この本の内容を、国立国会図書館で調べて学習してきてください」と頼んでみたのです。国立国会図書館(NDL=National Diet Library)は、日本で出版された本が納められる国内最大の図書館です。
私はWeb経由でしか調べられず、来館もできません。国立国会図書館サーチで調べられるのは書誌情報と、目次・要約データまでです。2026年1月刊の市販書はデジタル化対象外なので、本文はネット上のどこからも読めません。
加えて、仮に読めたとしても、著作物の本文をそのまま取り込んで再現することはできません。ご自身の著書であってもこの点は同じ扱いになります。
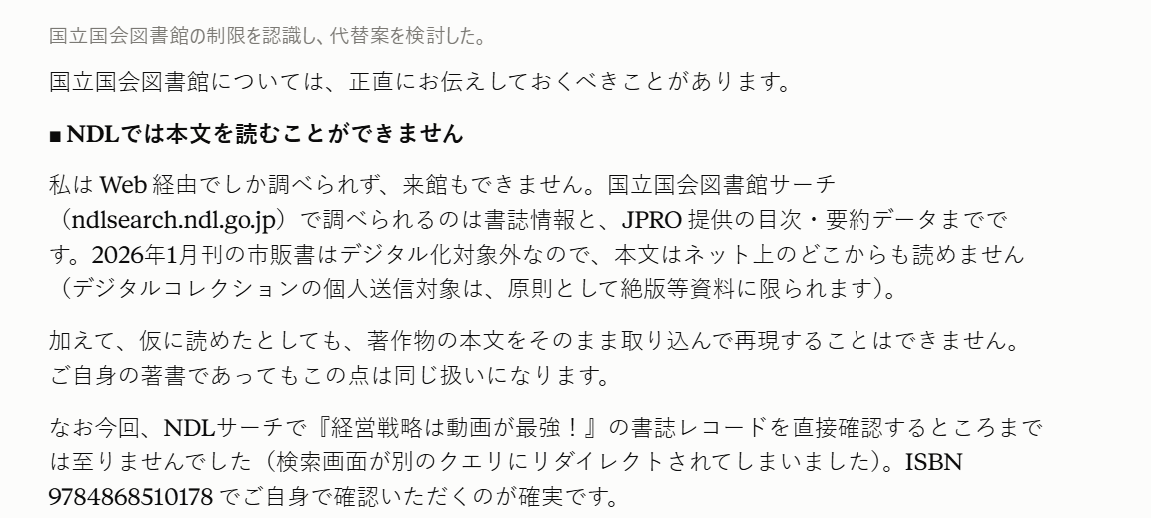
ところが、同じ回答の中でAIはこう続けました。「代わりに、ytbs.jpの章別解説記事から内容を把握しました」——そして第1章・第4章・第5章・第6章の要点を、正確に挙げてきたのです。私が自社サイトに書いていた内容です。
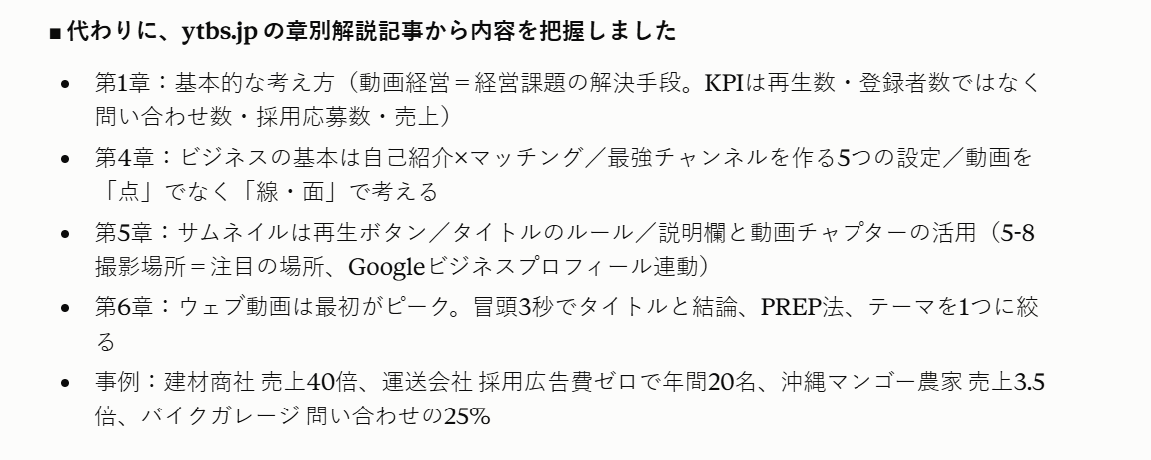
本でも会社でも、起きていることは同じです。出していない部分は読めず、出している部分は読める。そして出しておいた分だけは、正確に伝わります。
ところが、あとで気づきました。
2章と3章が、抜けている。
6つの章すべてに解説記事を出しているのに、2つだけ読まれていませんでした。6本を1本ずつ実測しました。
※ 表は横スクロールできます
| 解説記事 | 本文の長さ | 内部リンク | 検索から外す設定 | AIが読み取ったか |
|---|---|---|---|---|
| 1章 | 4,257字(最短) | 5本 | なし | ◯ 読まれた |
| 2章 | 9,161字 | 5本 | なし | ✕ 読まれず |
| 3章 | 9,251字(最長) | 5本 | なし | ✕ 読まれず |
| 4章 | 8,488字 | 5本 | なし | ◯ 読まれた |
| 5章 | 8,261字 | 5本 | なし | ◯ 読まれた |
| 6章 | 8,672字 | 5本 | なし | ◯ 読まれた |
2026年7月25日、6本すべての本文文字数・内部リンク数・検索設定(robots)・正規URL(canonical)を実測。数値は当社の実データです。
いちばん長い2本が落ちて、いちばん短い1本が拾われました。「量が足りないから読まれなかった」ではありません。検索から外す設定もしていませんし、リンクの数も同じ。技術的な条件は、6本ともまったく同じでした。
残った違いは、たったひとつでした
6本のタイトルを並べてみて、はっきりしました。
【経営戦略は動画が最強】YouTube運用の教科書、1章解説!
【経営戦略は動画が最強】YouTube運用の教科書、2章解説!
【経営戦略は動画が最強】YouTube運用の教科書、3章解説!
…6本すべて、この形です
「2章解説」というタイトルから、中身が何なのか、誰にもわかりません。私にもわかりません。本を持っている人だけが「ああ、あの章か」とわかる書き方です。
6本が同じ顔をしているので、AIから見ると区別がつかない。だから全部を読まずに、見つけた数本だけで答えを組み立てた——これが、いちばん説明のつく理由でした。
!正直に書いておきます
これは私の推測です。外から見て「AIがなぜその2本を読まなかったか」を100%特定することはできません。単に読まれなかっただけ、という可能性も残ります。ただ、考えられる技術的な原因を全部つぶした結果、残ったのがタイトルだけだった——ここまでは事実として確認できました。この6本が今後拾われるようになるかは、定期的に確かめて、この記事に追記していきます。
では、どうすれば見つけてもらえるのか
この経験から、ひとつの原則が出てきました。この記事でいちばんお持ち帰りいただきたい部分です。
★AIに見つけてもらえる文章とは
「そのページだけを見て、何が書いてあるかわかる」文章です。
「2章」は、本を持っている人にしか通じない身内の言葉でした。同じことが、どの会社にも起きています。社内では通じるけれど、外の人にはわからない書き方。AIは、その「外の人」です。
※ 表は横スクロールできます
| ありがちな書き方 | AIから見た状態 | こう直す |
|---|---|---|
| 「第2章解説」 | 何の話か不明 | 「動画マーケティングの3H戦略とは」 |
| 「サービスA」「Bプラン」 | 社内用語 | 「月額33万円・月単位の伴走支援」 |
| 「詳しくはこちら」 | 中身がゼロ | 「料金と契約期間はこちら」 |
| 「実績多数」 | 確かめようがない | 「建材商社で、YouTube活用により関連部門の売上が前年比40倍」 |
| 「お客様の声」 | 誰の何の話か不明 | 「運送会社・年間20名採用の事例」 |
| 「先日のセミナー報告」 | いつ・何のセミナーか不明 | 「商工会議所で話した採用動画の作り方」 |
共通しているのは「外の人が見てわかる言葉になっているか」だけです。難しい技術は要りません。御社のホームページにも、心当たりのある見出しはありませんか。
2026年内 限定
Claude経営伴走コンサルが、年内は半額です
生成AIを何に使うかの決め方、社員への広げ方、売上につなげる仕組みまで。Claudeで売上をつくる経営伴走コンサルティングでは、代表の酒井が1人で伴走します。
通常価格
月330,000円(税込)
2026年内の利用月は半額
月165,000円(税込)
初期費用なし・月単位でいつでもやめられます。年内の新しい受け入れは、あと5社までです(2026年10月4日時点)。※Claudeの利用料は別にかかります。
数字で見る「ネットに出ていない情報」の多さ
日本最大の図書館でも、ネットで読めるのは約13%
ここで、数字を1つだけお見せします。国立国会図書館が公表している、デジタル化資料の提供状況です。
※ 表は横スクロールできます
| 区分 | 点数 | 割合 | どこから読めるか |
|---|---|---|---|
| インターネット公開 | 68万点 | 約13% | 自宅のパソコンから誰でも |
| 図書館・個人送信 | 225万点 | 約44% | 利用者登録が必要(対象は絶版等の入手困難資料) |
| 館内提供のみ | 222万点 | 約43% | 図書館へ行かないと読めない |
| 合計(デジタル化資料) | 516万点 | 100% | — |
出典:国立国会図書館「資料デジタル化について」(デジタル化資料提供状況・令和8年/2026年6月末時点)。割合は公表値からの筆者計算。各点数は万点単位に丸められているため、内訳の合計と総計は一致しません。
つまり、日本でいちばん本を持っている場所でさえ、自宅のパソコンから本文を読めるのは約13%。しかもこの516万点は「デジタル化が済んだ資料」の数です。まだデジタル化されていない蔵書は、この分母にすら入っていません。蔵書全体で見れば、ネットで読める割合はさらに下がります。
「日本企業のHP開設率は93.3%」——この数字には、穴があります
会社の情報についても見てみましょう。総務省の調査によると、企業のホームページ開設率は93.3%(令和7年/2025年8月末時点)。「なんだ、ほとんど出しているじゃないか」と思いますよね。
ところが、この調査の対象は「常用雇用者100人以上の企業」だけです。
出典:中小企業庁「中小企業・小規模企業者の数(2021年6月時点)」(総務省・経済産業省「令和3年経済センサス-活動調査」再編加工)/総務省「令和7年通信利用動向調査」報告書(企業編)。通信利用動向調査の対象は常用雇用者100人以上の企業(公務を除く)。
つまり、日本の会社の84.5%を占める小規模事業者は、この「93.3%」に最初から数えられていません。国の統計ですら、小さな会社の情報発信の実態を測れていないのです。
だから、こちらから準備する
「そのうちAIが見つけてくれるだろう」——この期待だけは、いま捨ててください。第4章でご覧いただいたとおり、同じ日に公開し、同じリンク構造で、検索から外す設定もしていない6本のうち、2本は読まれませんでした。放っておいて解決する問題ではありません。
やることは、多くありません。まず「出す」。次に「区別がつく形にする」。この2つだけです。
| やること | なぜ効くのか | 目安 |
|---|---|---|
| 会社の基本情報を1ページにまとめて出す | 設立年・事業内容・実績が1か所に揃っていれば、AIは迷いません。バラバラだと、多く書いてあるほうが選ばれます(第3章) | 半日 |
| タイトルだけで中身が分かる形にする | 「2章 解説」では、AIにも人にも中身が分かりません(第4章)。何の話かをタイトルに書きます | 1本5分 |
| 説明していることを、そのまま記事にする | 商談で毎回している説明は、たいていネットのどこにも出ていません。出せば読まれます | 1本1〜2時間 |
▶ すでに間違った情報を答えられている場合は、直す順番が決まっています。AIが自社の情報を間違える|直し方の順番と、消えない誤りの正体に、誤りの4分類とAI4社の訂正窓口をまとめました。
ここまでで、いちばん大事な3つ
- ネット上に、誰でも見られる形で出ていること。生成AIが読んだのはインターネット上の文章だけです。会議も、電話も、紙の資料も、社員さんの経験も、1文字も入っていません。
- AIが見つけられる形で書かれていること。当社の開業年は書いてあったのに、ひとつのAIは拾えず、10回繰り返されていた別の数字をはめ込みました。書いてあるだけでは足りません。どこに・どんな形で置くかで、答えは変わります。
- 中途半端に書き残さないこと。いちばん危ないのは「何も書いていない」ではなく「中途半端に書いてある」状態です。何も無ければAIは「わかりません」と言いますが、中途半端だと、もっともらしい答えで埋めてしまいます。
よくある質問(FAQ)
QAIはインターネットを見ているのですか?+
Q生成AIは、世の中のことなら何でも知っているのではないのですか?+
Q自社のホームページがあれば、AIは正しく答えてくれますか?+
QAIが自社について間違えていたら、直せますか?+
Q有料版なら、正確に答えてくれますか?+
QどのAIがいちばん正確ですか?+
QAIに聞いた内容を、そのまま資料に使っていいですか?+
Q会社概要ページは、何を書けばいいですか?+
まとめ
生成AIは、世の中のすべてを知っているわけではありません。読めるのは、誰でも見られる形でネットに出ている分だけです(図1)。日本最大の図書館ですら、ネットで読めるのは約13%でした(表9)。
そして、穴があってもAIは止まりません。近くにあった別の情報で埋めて、もっともらしい答えを返します(図3)。当社も、設立年を9年ずれて答えられていました。
いちばん学びが大きかったのは、「出していても読まれないことがある」という実測です。6本のうち2本が落ち、しかも落ちたのはいちばん長い記事でした。差はタイトルだけでした。
AIは探しに来てくれません。こちらから、読める形にして出す。それが、いまできる唯一の準備です。
▶ 次に読む:AIが自社の情報を間違える|直し方の順番/AI可視性チェックの調べ方/GEO対策のやり方|AEO・SEO・LLMOとの違いと、6つの順番
※Claudeは、Anthropic社が提供する生成AIで、同社の商標です。当社は、同社の公認・提携先ではありません。当社の作業はClaude(Cowork)で行っています(2026年10月時点)。