ホーム > 生成AI・ITコーディネータ > AIクローラーを拒否する方法
AIクローラーを拒否する前に
robots.txtの設定と、70社を調べて分かった共通点
⚠この記事は「自社のホームページがAIに読まれる」話です。「社員がChatGPTに入れた情報が学習される」という心配は別の話なので、生成AIに入力してはいけない情報をご覧ください。
専門用語は苦手だ、という方もご安心ください。この記事に出てくる言葉は3つだけです。第2章で先に説明します。
- 止め方はあります。ただしAIの会社ごとに書き方が違い、貼り紙が効かない相手もいます
- 日本の主要企業70社を実際に調べました。ふつうの事業会社は38社中1社しか止めていません。新聞社は8社とも止めていました
- 当社は1社も止めていないのに、読まれていませんでした。入口の貼り紙は「どうぞ」なのに、受付が追い返していたのです
※設定の書き方だけ先に知りたい方は、第7章「止めたいとき、どこに何を書くのか」へどうぞ。
結論:止められます。ただ、その前に確かめてほしいことがあります
「AIに学習されたくない」というご相談をいただくと、たいてい最初に出てくるのが「ホームページに何か書けばいいと聞いた」という話です。半分は当たっています。AIの会社は、自分たちの見回りロボット(クローラー)の名前を公表していて、ホームページの入口に「ここはロボットは来ないでください」と書けば、多くの会社はそれに従います。書き方も難しくありません。1社につき2行です。
学習用のロボットだけを断るときの、いちばん短い書き方です。
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: CCBot
Disallow: /
学習用=GPTBot(OpenAI)・ClaudeBot(Anthropic)・Google-Extended(Google)・CCBot(Common Crawl)。検索用のOAI-SearchBot・Claude-SearchBot・PerplexityBotと、Google検索のGooglebotは書きません。書くと、そのAIの答えやGoogle検索に出なくなります。全部の名前と、断ったときに起きることは第7章の表10・表11にまとめています。
出典:OpenAI/Anthropic/Google/Common Crawl/Perplexityの公式ページ(2026年9月3日に当社が原文を確認)。
ただ、この記事でいちばんお伝えしたいのは、そこではありません。「読ませる/読ませない」は、実際には3つの関門で決まっているということです。
図1:読まれるかどうかを決めている、3つの関門
第1の関門は、あなたが入口に貼った紙です。これは意思表示です。第2の関門は、受付が実際にどうしたかです。ここは貼り紙とは無関係に動きます。第3の関門は、そもそも貼り紙が効かない相手です。これは各社が自分でそう公表しています。
そして当社で実際に起きていたのは、第2の関門の話でした。入口には「どうぞ読んでください」と貼ってあるのに、受付はロボットを追い返していた。これに気づいたのが2026年9月3日です。詳しくは第5章に書きました。
①自社のホームページを読まれる=この記事です。
②社員がAIに入れた情報が使われる=生成AIに入力してはいけない情報で扱っています。契約の種類と設定で変わる話です。
③人間の競合に真似される=ノウハウを公開すると、競合に真似されませんかで扱っています。
先に、言葉を3つだけ(ここを読めば、あとは全部わかります)
この手の記事は、いきなり英語まじりの用語が出てきて読む気をなくします。なので先に、この記事で使う言葉を全部まとめておきます。会社の建物と、そこに見回りに来るロボットにたとえます。
| 言葉 | 読み方 | 会社にたとえると | ひとことで言うと |
|---|---|---|---|
| クローラー | — | 見回りに来るロボット | ホームページを自動で読みに来るプログラム。AI各社が動かしています |
| robots.txt | ロボッツ・テキスト | 入口に貼る「お願い」の紙 | 「ここはロボットは入らないでください」と書いておくファイル。誰でも見られます |
| サーバー | — | 受付 | ホームページを実際に見せている機械。通すか追い返すかを最終的に決めています |
あとは、このたとえの中で出てくる言葉が少しあるだけです。
この3つ(と、おまけの3つ)さえ頭に入れば、あとは全部読めます。以降、英語の名前が出てきたら「ああ、ロボットの名前ね」と読み飛ばしていただいて構いません。
日本の主要企業70社の「貼り紙」を、実際に見に行きました
- 「AIに学習されたくないと考えている日本企業は何割か」を直接聞いた公的な調査は、今回の調査範囲では見つかりませんでした
- だから推測で書く代わりに、70社分の貼り紙を実際に見に行きました
2026年9月3日に、日本の上場事業会社55社と、新聞・通信・放送・出版15社の計70社について、入口の貼り紙(robots.txt・誰でも見られる公開ファイル)を1件ずつ確認しました。中身を確認できたのは53社です。⚠確認できなかった17社は「止めていない」に数えていません。見つからないことは、無いことの証拠にならないからです。
| 分類 | 調べた社数 | 中身を確認できた | AIを止めていた | 割合 |
|---|---|---|---|---|
| 上場している事業会社 | 55 | 38 | 1 | 2.6% |
| 新聞・通信社 | 8 | 8 | 8 | 100% |
| 放送(NHK・民放) | 3 | 3 | 1 | 33% |
| 出版・ビジネス誌・IT媒体 | 4 | 4 | 0 | 0% |
| 合計 | 70 | 53 | 10 | 18.9% |
出典:当社調べ。2026年9月3日に各社の公開robots.txt(入口の貼り紙)を取得し、AI関連の23のロボット名について「来ないでください」の記載があるかを判定。分母は中身を確認できた社数。事業会社は製造・小売・IT・金融・建設・運輸・医薬から選定。
図2:業種によって、これだけ違います
止めていた10社は、中途半端には止めていませんでした
| 会社 | 23のロボット名のうち | 備考 |
|---|---|---|
| 読売新聞・東京新聞・中日新聞 | 23(すべて) | 全面的に拒否 |
| 朝日新聞 | 22 | — |
| 毎日新聞・産経新聞・時事通信 | 20 | 一部は記載そのものがない |
| 日本経済新聞 | 18 | 今回の調査対象外の名前で、さらに6つ拒否 |
| NHK | 12 | — |
| サイバーエージェント | 3 | 事業会社で唯一。ただしChatGPTのロボットは止めておらず、「ゆっくり来てください」と伝えているだけ |
事業会社で唯一止めていたサイバーエージェントも、全部ではなく3つだけを選んでいました。「全部か0か」ではないという実例です。
逆に、わざわざ「どうぞ」と書いている会社もありました
| 会社 | 書いてあった内容 |
|---|---|
| 武田薬品工業 | ChatGPTとClaudeのロボットに対して「どうぞ入ってください」と明記。止めないことを、わざわざ書いています |
| 鹿島建設 | 特定のフォルダだけ断っています。会社全体の拒否はしていません |
| 時事通信 | Appleの検索用ロボットは通し、学習用ロボットだけ断っています |
出典:当社調べ。各社の公開robots.txtを2026年9月3日に取得。この貼り紙は誰でも閲覧できる公開ファイルです。ここでは「そう書いてあった」という事実だけを記載しており、各社の判断の当否について当社は評価していません。
選択肢は「全部止める」か「何もしない」の2つではありません。場所を選んで止める、学習だけ止める、止めないと明記する。どれも実例があります。
世界の数字と並べると
Cloudflareという会社が2025年6月に自社の通信を測ったところ、世界の上位1万サイトのうち貼り紙が見つかった3,816件で、AIのロボットを名指しして許可か拒否をしていたのは546件(約14%)でした。⚠分母は1万ではなく3,816です。ニュースサイトでは、オックスフォード大学ロイター研究所の調査で、10か国の主要ニュースサイトの48%が2023年12月時点でChatGPTのロボットを拒否していました(2年9か月前・大手ニュースサイトのデータで、中小企業の姿ではありません)。
出典:Cloudflare「From Googlebot to GPTBot: Who’s crawling your site in 2025」(2025年7月1日公開・2025年6月のデータ)/Reuters Institute for the Study of Journalism「How many news websites block AI crawlers?」(2024年2月22日公開・2023年12月時点)。いずれも発表元のページを当社が直接確認しています(2026年9月3日)。
調べ方も分母も違うので、日本の2.6%と並べて「日本は遅れている」とは読めません。言えるのは、ものやサービスを売っている会社は、日本でも世界でも多数派は止めていない、ということです。
うちの貼り紙は、たった6行です
当社の貼り紙(robots.txt)です。人に「どうしますか」と聞かれておいて自分の手の内を見せないのは不誠実だと思うので、当社のものをそのまま出します。https://ytbs.jp/robots.txt を開けば、いまも同じものが見られます。
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://ytbs.jp/sitemap.xml
Sitemap: https://ytbs.jp/sitemap.rss
当社の実物。2026年9月3日にブラウザで取得(受付の対応は200=どうぞ)。
英語が並んでいますが、言っていることは単純です。日本語にするとこうなります。
| 書いてある行 | 日本語にすると |
|---|---|
| User-agent: * | ここから先は、すべてのロボットへのお願いです |
| Disallow: /wp-admin/ | 管理画面の部屋には入らないでください |
| Allow: /wp-admin/admin-ajax.php | ただし、その中の1つだけは通してください(表示に必要なため) |
| Sitemap:(2行) | ページの一覧はここにあります、という案内 |
| GPTBot・ClaudeBot などのロボット名 | 1つも書いていません。つまり、AIを1社も止めていません |
なぜ止めていないのか
理由は3つあります。
見つけてもらうために出している
当社が公開しているのは、支援の考え方と、自分で測った数字です。これは読まれるために書いたもので、隠すために書いたものではありません。読まれない前提なら、そもそも公開しません。
出せない情報は、最初から載せていない
お客様から預かった情報、未公開の価格、個人情報。これらは断るのではなく、最初からホームページに載せません。載せていないものは、止める必要がありません。
止めた場合の影響が読めない
止めると何が起きるかは、正直に言えば当社にも分かりません。当社は意図して止めた経験がないので、この記事でも「止めるとこうなる」と断定はしません(第10章)。
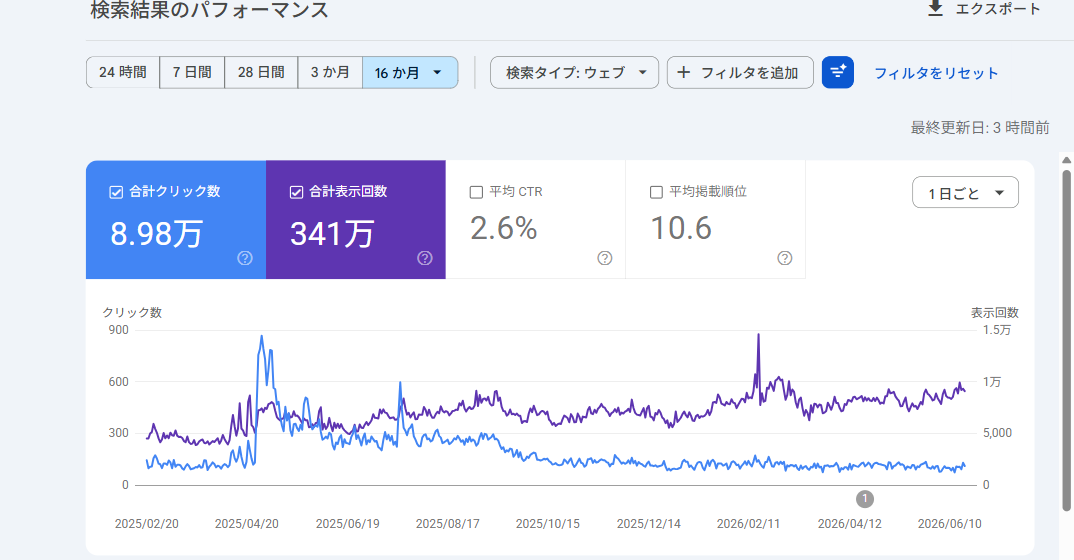
「どうぞ」と貼ってあるのに、受付が追い返していました
ウェブの図書館(Common Crawl)の公開目録で、当社の資料が何ページ置かれているかを、2026年1月から8月までさかのぼって数えました。
| 集めた月 | 実際に回っていた期間 | 置かれた当社の資料 | 受付の対応 |
|---|---|---|---|
| 2026年1月 | 1/12〜1/25 | 303ページ | 200(どうぞ) |
| 2026年2月 | 2/6〜2/19 | 304ページ | 200(どうぞ) |
| 2026年3月 | 3/5〜3/17 | 215ページ | 200(どうぞ) |
| 2026年4月 | 4/10〜4/23 | 0 | 403(お断り) |
| 2026年5月 | 5/8〜5/21 | 0 | 403(お断り) |
| 2026年6月 | 6/5〜6/18 | 0 | 403(お断り) |
| 2026年7月 | 7/10〜7/23 | 0 | 403(お断り) |
| 2026年8月 | 8/7〜8/20 | 0 | 403(お断り) |
| 2026年9月 | 9/4〜9/17 | 91ページ | 200(どうぞ) |
出典:Common Crawl公式の目録(index.commoncrawl.org)に当社ドメインを問い合わせ、記録を全部取得して集計。2026年9月3日実施(9月分は2026年9月25日に同じ方法で取得)。⚠件数がぶれないよう、同じ集計を2回ずつ別々に実行し、9か月分すべてが完全に一致することを確認しています。
図3:2026年4月を境に、ぱたりとゼロになりました
どうやって見つけたか
この記事を書くまで、当社は気づいていませんでした。「うちは止めていません」と書く前に、実際に読まれているかを確かめて見つけました。ブラウザからは同じ日にふつうに表示されます。人には見えていて、ロボットにだけ「お断り」が返っていました。
原因が分かりました|受付は、サーバーの設定でした
翌9月4日、契約しているサーバー会社の管理画面で原因が見つかりました。「セキュリティ」の中の「ウェブサイトアクセス制御」がオンになっていました。
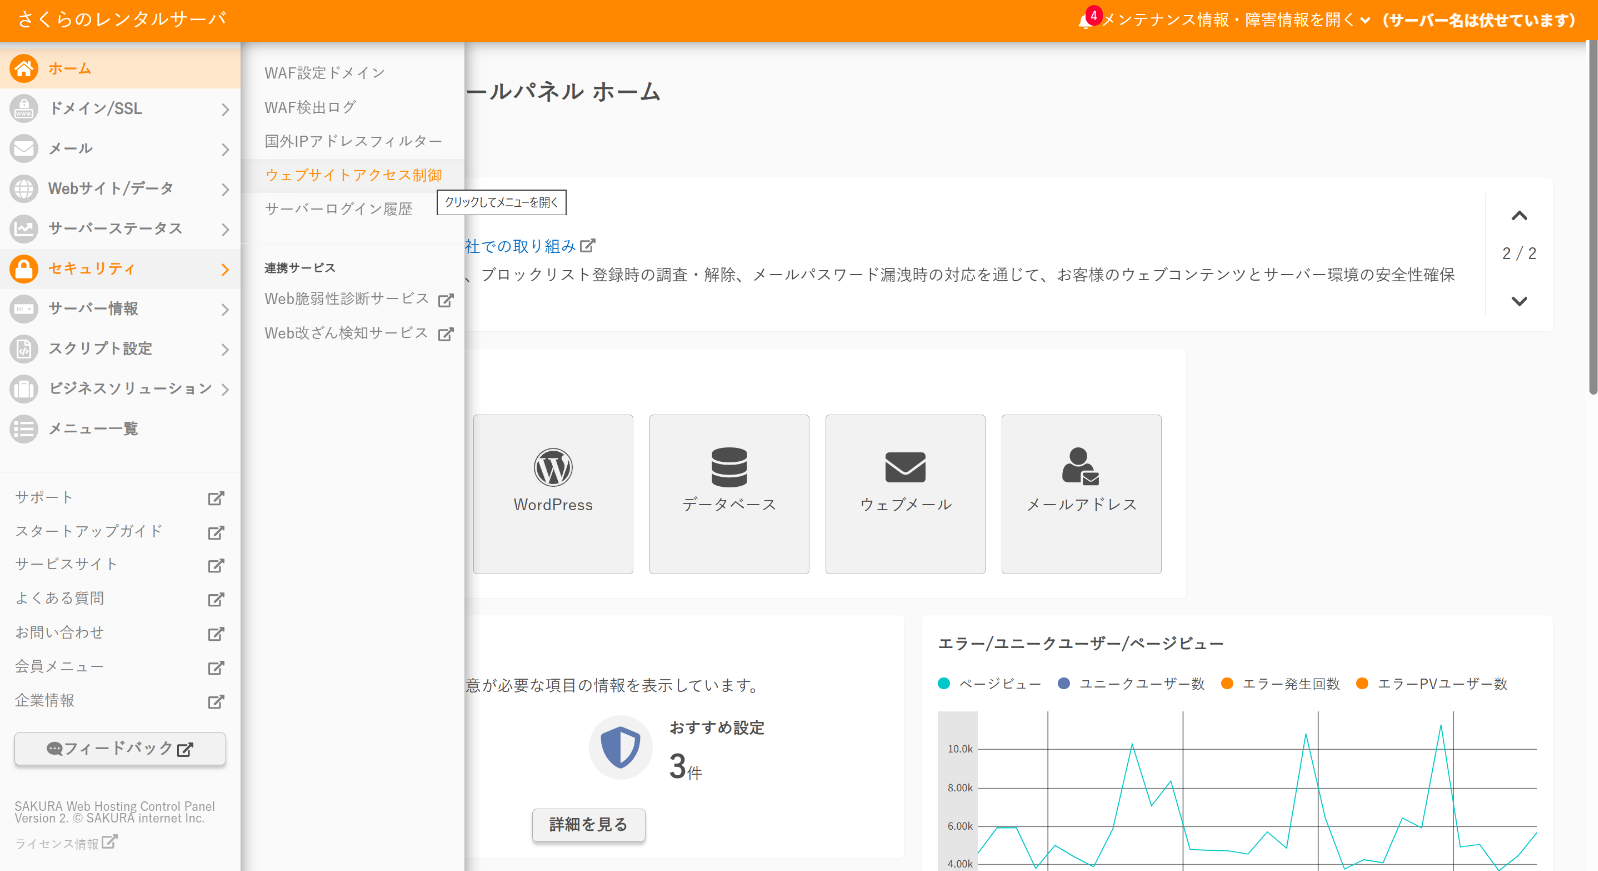
開いてみると、こう書いてありました。
カテゴリは3つありました。そしてオンになっていたのは、いちばん上の1つだけでした。
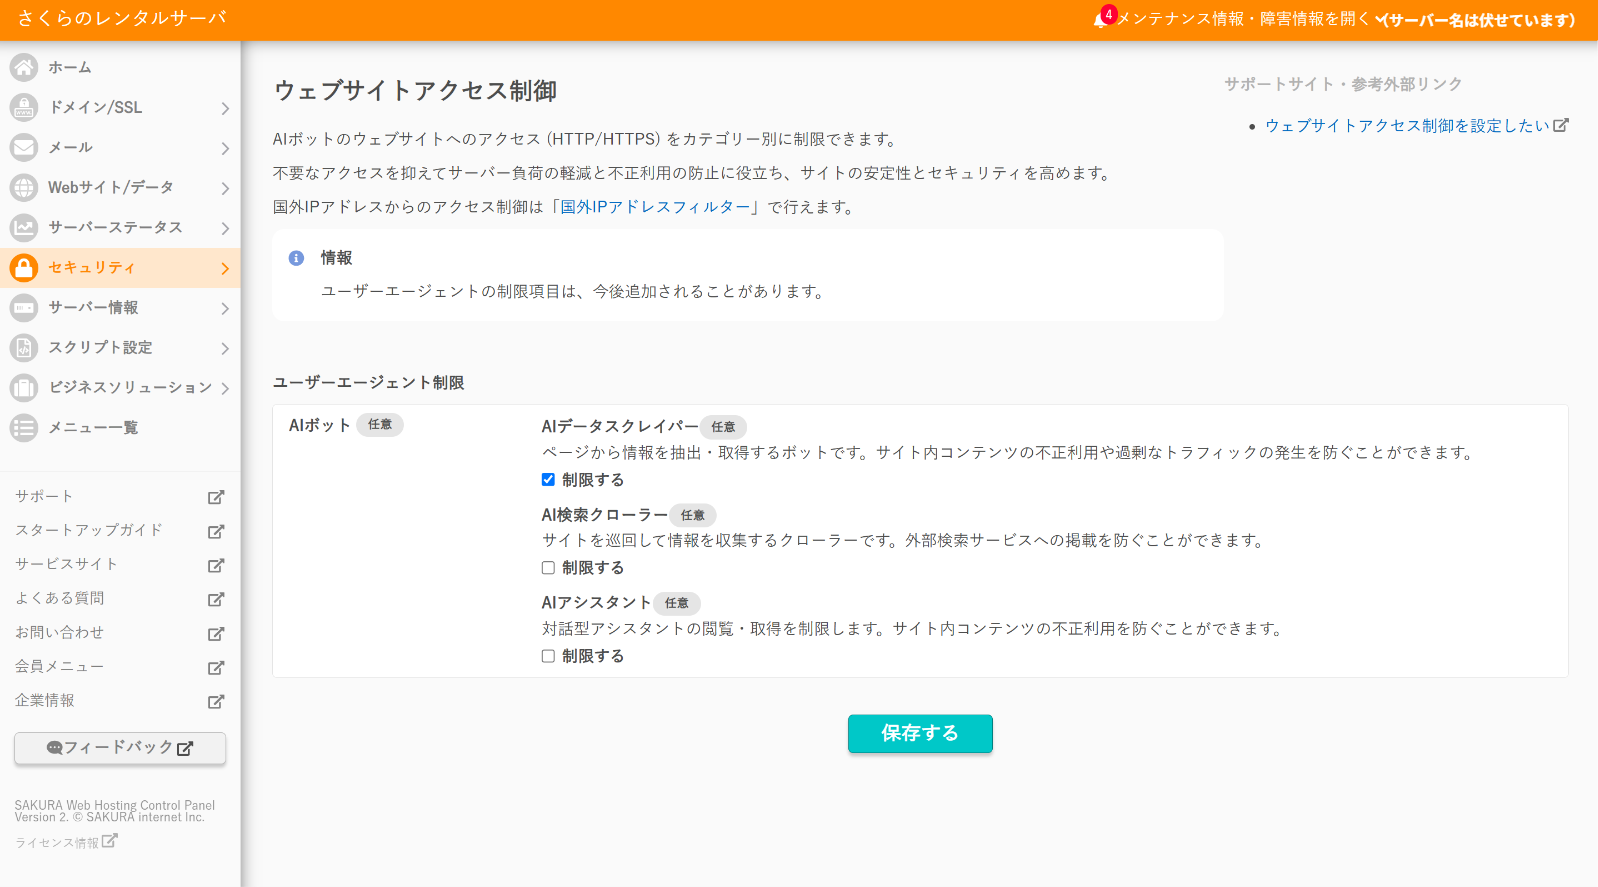
⚠ 誤解のないように書いておきます。これはサーバー会社が用意している、まっとうな機能です。クローラーの巡回はサーバーの負荷になるので、止められること自体は役に立ちます。問題は機能ではなく、当社がそれに気づいていなかったことだけです。
ところが、名前と中身は一致していませんでした
オンは「AIデータスクレイパー」だけで、「AI検索クローラー」は制限していません。「学習は断るが、検索は通す」つもりでした。ところが、ロボットの名前を名乗って自社サイトを取得すると、こうなりました。
| 名乗った名前 | 用途 | 設定オンのとき (9月4日 朝) | オフにした後 (9月4日 10時39分) |
|---|---|---|---|
| CCBot | 学習(ウェブの図書館) | 403 お断り | 200 どうぞ |
| GPTBot | 学習(ChatGPT) | 403 お断り | 200 どうぞ |
| ClaudeBot | 学習(Claude) | 403 お断り | 200 どうぞ |
| Claude-SearchBot | 検索(Claude) | 403 お断り | 200 どうぞ |
| meta-externalagent | 学習(Meta) | 403 お断り | 200 どうぞ |
| Bytespider | 学習 | 403 お断り | 200 どうぞ |
| (参考)Googlebot・bingbot・OAI-SearchBot・PerplexityBot ほか | 検索など | 200 どうぞ | 200 どうぞ |
当社実測。設定オンのときの測定は2026年9月4日の朝、オフにした後の測定は同日10時39分(6つの名前×3ページ=21件すべて200)。いずれも未ログイン・キャッシュ回避つき。
4行目を見てください。「AI検索クローラー」は制限していないのに、Anthropicの”検索用”であるClaude-SearchBotも断られていました。
だから、名前を見て安心するのではなく、実際に取ってみて確かめるしかありません。
⚠ これは「設定の分類が間違っている」という話ではありません。当社が自社のサーバーの応答を測って言えるのは、ここまでです。どの名前がどのカテゴリに入るのかは公表されていないので、そこは分かりません。なお、この間はClaudeの検索で当社が出にくくなっていた可能性があります。
直しました。ただし「戻った」とはまだ言えません
9月4日にこの設定をオフにし、同じ測り方で21件すべてが200(どうぞ)になったことを確かめました(表7の右端)。⚠ただし、200が返ることと、図書館の目録に載ることは別です。目録はおよそ月に1回公開されます。
追記(2026年9月25日):9月分の目録(クロール期間 9月4日〜17日)では、当社の資料が91ページ、ふたたび置かれていました(受付の対応は200=どうぞ・取得日は9月6日・表6の最終行)。設定をオフにした2日後に、図書館の見回りが来て、通ったということです。10月分が出たら、もう一度確かめます。
| 内容 | |
|---|---|
| 9月3日に分かった | 入口の貼り紙にAIのロボット名はゼロ。ブラウザからは正常に表示される。図書館への収録は2026年4月からゼロで5か月連続。応答は403 |
| 9月4日に分かった | 原因はサーバーの「ウェブサイトアクセス制御」がオンだったこと。オフにしたら、6つとも200に戻った |
| まだ分かっていない | いつ、誰がこの設定を入れたのか。そして図書館に再び載るかどうか(次の目録が出てから確かめます) |
この話から、持ち帰っていただきたいこと
2つあります。
② 設定画面で「検索は残す」にしたつもりでも、検索用のロボットが止まっていることがあります。
止めたい側の会社でも、同じことは起きます。止め方を調べる前に、いまどうなっているかを確かめてください(やり方は第13章・5分・0円)。
見回りのロボットは、1種類ではありません
「AIのロボット」とひとくくりにされがちですが、各社は用途ごとに別の名前を用意しています。理由は単純で、会社側が用途ごとに選べるようにするためです。OpenAI(ChatGPTの会社)は、公式の説明の中で「それぞれの設定は互いに独立している」と書いています。
| 種類 | 何のために来るのか | 断るとどうなるか | 貼り紙で止まるか |
|---|---|---|---|
| ① 勉強しに来る | AIを賢くするための材料集め。GPTBot・ClaudeBot・Google-Extended・CCBotなど | 今後の内容が勉強の材料から外れる、という意思表示になります | 止まります |
| ② 検索のために来る | AIが答えるときに、根拠として引用するため。OAI-SearchBot・PerplexityBotなど | AIの答えに出てこなくなります。各社が公式にそう書いています | 止まります |
| ③ お客さんに頼まれて来る | 利用者が「このページを読んで」と頼んだときに見に行く。ChatGPT-User・Perplexity-Userなど | — | 止まらないことがあります |
出典:OpenAI「Overview of OpenAI Crawlers」、Anthropic「Does Anthropic crawl data from the web…」、Google「Google’s common crawlers」、Perplexity「Perplexity Crawlers」、Common Crawl「CCBot」。いずれも当社が2026年9月3日に原文を確認しています。
とくに大事なのが3行目です。人が「このページを読んで」とAIに頼んだ場合は、貼り紙に書いても止まらないことがあると、各社が自分で公表しています。詳しくは第9章で扱います。
止めたいとき、どこに何を書くのか
| やりたいこと | robots.txtに書く名前 |
|---|---|
| 学習に使われるのを断りたい | GPTBot(ChatGPT)/ClaudeBot(Claude)/Google-Extended(Gemini)/CCBot(ウェブの図書館) |
| AIの検索には出したい | OAI-SearchBot/Claude-SearchBot/PerplexityBot は書かない(書くと、そのAIの答えに出なくなります) |
| Google検索は残したい | Googlebot は書かない。⚠Google-Extendedを断ってもGoogle検索には影響しません |
以下は、2026年9月3日時点で各社の公式ページを開いて確認した一覧です。英語の名前は「ロボットの名前」だと思って、読み飛ばしていただいて構いません。大事なのは右の2列です。
⚠各社の方針は変わります。この表は「そのとき何と書いてあったか」の記録であって、永久に正しいものではありません。
| 提供元 | ロボットの名前 | どんなロボットか | 断ると(公式の説明) |
|---|---|---|---|
| OpenAI (ChatGPT) | GPTBot | 勉強しに来る | 内容を勉強に使うべきでない、という意思表示になります |
| OAI-SearchBot | 検索のために来る | ChatGPTの検索の答えに表示されなくなります | |
| ChatGPT-User | お客さんに頼まれて来る | 利用者が始めた動作なので、お願いが適用されない場合があります | |
| Google (Gemini) | Google-Extended | 勉強しに来る | Google検索の掲載には影響しません(順位にも関係しません) |
| Anthropic (Claude) | ClaudeBot | 勉強しに来る | 今後の資料を勉強の材料から外す合図になります |
| Claude-SearchBot | 検索のために来る | 検索結果での露出と正確さが下がりえます | |
| Claude-User | お客さんに頼まれて来る | 利用者の質問に対して内容を取得できなくなります | |
| Common Crawl | CCBot | 図書館に集めに来る | 図書館に収録されなくなります(多くのAIの材料) |
| Perplexity | PerplexityBot | 検索のために来る(勉強用ではないと明記) | 検索結果に載らなくなります。公式は許可を勧めています |
| Perplexity-User | お客さんに頼まれて来る | 利用者が要求した取得なので、一般にお願いを無視します | |
| Apple | Applebot | Siri・iPhoneの検索 | Apple製品の検索結果に出なくなります |
| Applebot-Extended | 勉強に使ってよいかだけ判定 | 勉強だけ断れます。検索結果には引き続き出ます | |
| Meta (Facebook) | meta-externalagent | 勉強しに来る | 反映まで最大24時間かかります |
| Microsoft (Copilot) | 入口の貼り紙ではありません | — | ページ1枚ごとに別の書き方で伝える別のしくみです |
出典(すべて2026年9月3日に当社が原文を確認):OpenAI/Google/Anthropic/Common Crawl/Perplexity/Apple/Meta/Microsoft。
担当者に伝えていただきたい、間違えやすい4点
実際に設定するのは、社内のWeb担当者か制作会社になると思います。その方に渡していただきたい注意を、公式の説明から3つ、当社の経験から1つ拾いました。
貼る場所は玄関だけ
この紙はホームページの一番上の階層にしか効きません。奥のフォルダに置いても読まれません。またアドレスの頭が違う場合(wwwの有無など)は別の建物の扱いになります。
Appleの巻き添え
貼り紙にAppleの記述がなく、Googleの記述だけがある場合、AppleはGoogle向けの指示に従うとAppleが公式に書いています。意図せず巻き添えになります。
「ゆっくり来て」は社ごとに違う
巡回の間隔をあける指定は、Googleは対応していませんが、Anthropicは公式に対応と書いています。「どこでも効く」と思って書くと、思ったとおりになりません。
サーバー側の設定も見る
貼り紙とは別に、サーバー会社の管理画面でAIのロボットを止める機能があります。当社の契約サーバーでは「セキュリティ」の中の「ウェブサイトアクセス制御」でした。貼り紙に何も書いていないのに止まっていた実例は第5章です。
設定の手順そのものをもっと詳しく知りたい方は、テクニカルSEOは自分でできる|Claudeで直す手順と所要時間をご覧ください。この記事は、手順ではなく止めるかどうかの判断を扱っています。
「入らないで」と「名簿に載せないで」は、別のお願いです
Googleの公式ページに、はっきり書いてあります。
入口の貼り紙は、あくまで「入らないでください」というお願いです。検索結果から消すための道具ではありません。実際、貼り紙で断ったページでも、他のサイトからリンクされていれば、アドレスだけが検索結果に出ることがあります。
では検索結果から消すにはどうするかというと、noindex(ノーインデックス)という別のお願いを使います。これはページ1枚ごとに貼る「名簿に載せないで」の札です。ここで、よく起きる事故があります。
理屈は単純です。入口で「入らないで」と言っているので、ロボットは部屋に入れません。入れないので、部屋の中に貼った「名簿に載せないで」の札を読めません。読めないので、効きません。
つまり「念のため両方やっておこう」が、いちばん危ない選択になります。
| 入口の貼り紙(robots.txt) | 名簿の札(noindex) | |
|---|---|---|
| 言っていること | 入らないでください | 検索結果に出さないでください |
| 貼る場所 | 建物の入口に1枚 | 部屋ごと(ページ1枚ごと) |
| 検索結果から消えるか | 消えません(アドレスだけ出ることがあります) | 消えます |
| 両方やったら | 札が読まれず、効かなくなります | |
出典:Google 検索セントラル「robots.txt の概要」「noindex で検索インデックス登録をブロックする」。当社が2026年9月3日に原文を確認。引用は Creative Commons Attribution 4.0 License に基づきます。
当社は、609ページに「名簿に載せないで」の札を貼った側です
これは他人事ではありません。当社は古い記事609ページに noindex を貼って、検索結果から下げました。読まれる価値が薄くなった記事を残しておくと、サイト全体の評価を下げるからです。
このとき、入口の貼り紙はいっさい触っていません。触ってしまうと、いま説明した理由で札が効かなくなるからです。「検索から下げたい」なら札、「読みに来ないでほしい」なら入口の貼り紙。目的が違えば、道具も違います。
なお、これは「AIに自社のデータを渡す」話とも別です。渡す側の話はClaudeに自社データを学習させる前に|「学習させ方」より、渡す量を見てください、AIに入力してはいけない情報は生成AIに入力してはいけない情報で扱っています。この記事は読まれる側の話です。
貼り紙では止められないものが、4つあります
ここは、この記事でいちばん誠実に書きたい章です。入口の貼り紙(robots.txt)は万能ではありません。そしてそれは当社の推測ではなく、各社が自分で公表していることです。
| 対象 | 止まるか | 理由 |
|---|---|---|
| これから来る勉強用のロボット | 止まります | 各社が公式に手段を用意しています |
| すでに勉強された分 | 止まりません | 貼り紙はこれから来る相手へのお願いです。過去に取り込まれた分を取り消すものではありません |
| 他人が書いた自社の情報 | 止まりません | 取引先の紹介ページ、業界メディアの記事、SNSの投稿。自社を閉じても、他人の建物には残ります |
| 口コミ・まとめサイト | 止まりません | 自社が管理していない場所です。むしろ自社を閉じると、こちらの比重が上がります |
| 人がAIに頼んで読ませたとき | 止まらないことがあります | OpenAI・Perplexity・Metaの3社が、公式にそう書いています |
最後の行を、具体的に引くとこうなります。OpenAIは「利用者が始めた動作なので、お願いが適用されない場合がある」。Perplexityは「利用者が要求した取得なので、一般にお願いを無視する」。Metaは「迂回することがある」。3社とも、自分で公表しています。
つまり、誰かがあなたの会社のページのアドレスをAIに貼り付けて「これを要約して」と頼めば、入口に何が貼ってあっても読まれる可能性があるということです。ここは技術で塞げません。
ここから後半です。残りは4つだけ
後半は「止めたら何が起きるか」「それでも止めたほうがいい場合」「3択の判断表」「今日やること」です。お急ぎの方は、第12章の判断表と第13章の3ステップだけでも十分に持ち帰れます。
止めたら、何が起きるか
まず、はっきりさせておきます。当社は、AIを意図的に断ったことがありません。(第5章のとおり、知らないうちに断っていた期間はありました)ですから「断ったら問い合わせが何割減った」というようなデータを、当社は持っていません。持っていないものを、あるように書くつもりはありません。
言えるのは2つです。ひとつは各社が公式に書いている「断るとこうなる」。もうひとつは当社が実際に測っている、AI経由の訪問です。
| 場面 | 何が起きるか |
|---|---|
| お客様が下調べするとき | AIの答えに自社が出てこなくなります。比較検討の候補に入る前に消えます(OpenAI・Anthropic・Perplexityが公式に明記) |
| 求職者が会社を調べるとき | 応募前にAIで下調べする人が増えています。出てこない会社は、そもそも検討されません |
| AIが自社について答えるとき | 自社のホームページが読めないと、他人が書いた情報だけで答えが作られます。誤りがあっても、訂正する材料がありません |
| Google検索 | Geminiの勉強用ロボットを断っても検索の掲載には影響しないとGoogleが明記。ここは分けて考えられます |
当社が測れている数字
当社のアクセス解析には「AI Assistant」という区分があり、AI経由で来た訪問がここに入ります。2025年8月22日から2026年8月22日までの1年間で、107回、全体の0.11%でした。
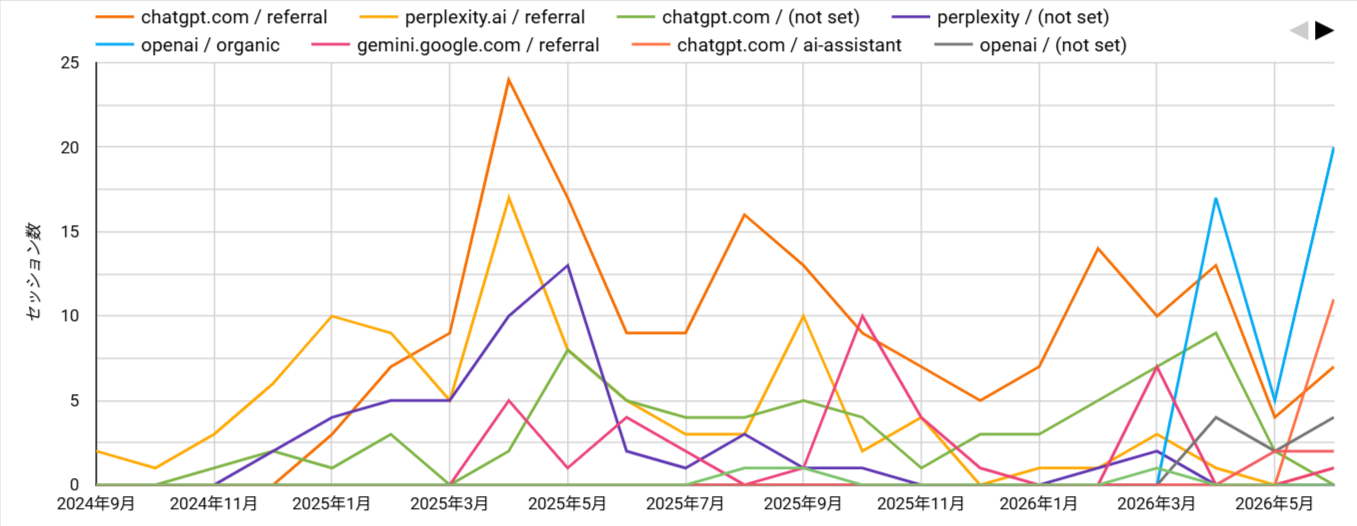
この0.11%を、当社は「AI経由は、まだ主要な入口ではない」の裏づけとして使っています。盛るつもりはありません。ただし、これは下限の数字です。この区分に入らない経路もあるので、実際はもう少し多いはずですが、どのくらい多いかは分かりません。
⚠「増えている」とも、この記事では書きません。この区分のラベル自体が付き始めたのが最近で、分子と分母の期間が揃っていないためです。期間の揃っていない数字で傾向を語らないというのが、当社の決まりです。
当社の考えに反するデータも、出しておきます
「読ませたほうがいい」と当社は考えていますが、それに反する実測もあります。Cloudflareが2025年6月に測ったところ、AI各社が読みに来た回数に対して、実際に返ってきた訪問の比率は、最も低い社で約7万回に1回でした。7万回読まれて、訪問は1回という計算になります。
⚠この数字は、発表元自身が「一部の経路では訪問が数えられないため、比率が実際より大きく出ている可能性がある」と注意書きをしています。それでも、「読ませれば訪問が返ってくる」という単純な話ではないことは示しています。
また同社は2026年6月時点で、ロボットからの要求の52%がAIの勉強目的(1年前は22%)とも報告しています。読まれる量そのものは、確実に増えています。
出典:Cloudflare「The crawl before the fall… of referrals」(2025年7月1日公開・2025年6月19〜26日のデータ)/同「Content Independence Day, one year on」(2026年7月1日公開)。当社が2026年9月3日に原文を確認。⚠いずれも同社のネットワークを通る通信の実測で、日本のサイト単独の数字ではありません。
それでも止めたほうがいい場合
次のような領域を持っている会社は、止めることを検討する意味があります。
| 点検 | 見つかったら |
|---|---|
| 会員限定・お客様専用のページが、誰でも見られる状態になっていないか | 止めるより先に、ログインを必須にするのが正しい対処です |
| 未公開の価格や取引条件が載っていないか | 止めることに意味があります。ただし人にも見えているので、まず見せてよいかを判断してください |
| 個人情報・お客様から預かった情報が載っていないか | 止めるのではなく、消してください。AIの問題ではなく、公開してはいけないものが公開されている問題です |
| テスト用・作りかけのページが残っていないか | 止めるより、消すか非公開にするほうが確実です |
強調したいのは3行目です。「AIに読まれたくない情報」の多くは、実は「誰にも読まれてはいけない情報」です。AIを断っても、人はふつうに見られます。検索にも載ります。画面を撮られることもあります。
ですから、ご相談をいただいたときに当社が最初に聞くのは「何を止めたいですか」ではなく、「それは、そもそもホームページに載せておいてよい情報ですか」です。ここで「載せなくていい」となる場合が、実際にあります。止める設定より先に、載せないという選択があります。
3つのうち、どれにしますか
| 選択 | 得るもの | 失うもの | 向いている会社 | 実例 |
|---|---|---|---|---|
| 全部読ませる | AIの答えに出る。引用される | 勉強に使われることは止められない | 公開している情報で見つけてもらいたい会社 | 今回調べた事業会社の37社/武田薬品は許可を明記/当社 |
| 一部だけ止める | 見せたくない場所だけ守れる | 設定が増えます。間違えると検索ごと消えます | 会員向け・非公開価格を持つ会社 | 鹿島建設(特定フォルダのみ)/時事通信(勉強だけ断る)/サイバーエージェント(3つだけ) |
| 全部止める | 勉強に使われる範囲が減る(ゼロにはなりません) | 下調べの段階で候補から消えます | 記事そのものが商品の会社。Webから集客も採用もしない会社 | 読売新聞・東京新聞・中日新聞(23すべて) |
業種で決まる、という言い方は乱暴です。ただ、今回の実測を並べると傾向ははっきりしています。記事そのものを売っている会社は止める。ものやサービスを売っている会社は止めない。あなたの会社が後者なら、多数派は「止めない」です。
そして、どれを選ぶにしても、費用はかかりません。入口の貼り紙を直す作業自体は0円で、5分もあれば終わります。かかるのは、判断のための時間だけです。
2026年内 限定
Claude経営伴走コンサルが、年内は半額です
AIに正しく読まれる直し方、記事の作り方、問い合わせにつなげる仕組みまで。Claudeで売上をつくる経営伴走コンサルティングでは、代表の酒井が1人で伴走します。
通常価格
月330,000円(税込)
2026年内の利用月は半額
月165,000円(税込)
初期費用なし・月単位でいつでもやめられます。年内の新しい受け入れは、あと5社までです(2026年10月4日時点)。※Claudeの利用料は別にかかります。
今日やること、3ステップ(10分・0円)
| やること | 所要 | 費用 | |
|---|---|---|---|
| 1 | ブラウザのアドレス欄に「自社のホームページのアドレス/robots.txt」と入れて開く。AIのロボット名が書いてあるか見る | 1分 | 0円 |
| 2 | 実際に読まれているかを確かめる。ウェブの図書館に、自社の資料が何ページ置いてあるか数える(やり方は下) | 5分 | 0円 |
| 3 | 第12章の3つから1つ選び、社内で決める。決めたら、決めたことを記録しておく | — | 0円 |
ステップ2のやり方(当社がやったのと同じ手順)
Common Crawlは、目録を誰でも無料で使えるように公開しています。ブラウザのアドレス欄に、次の形で入力するだけです。「自社ドメイン」の部分を、自社のホームページのアドレス(例:example.co.jp)に置き換えてください。
https://index.commoncrawl.org/CC-MAIN-2026-34-index?url=自社ドメイン/*&output=json
見方は3つだけです。
文字がずらっと出る
読まれています。止めたい場合は、これから設定すれば効きます。
「No Captures found」と出る
その月は1ページも収録されていません。止めているなら意図どおり。止めていないのにこれなら、当社と同じ状態です。
「403」という数字が並ぶ
受付が追い返しています。意図的でないなら、サーバー会社かWeb担当者に確認してください(下の文面をお使いください)。
Web担当者・制作会社に、そのまま送れる文面
ご自身で作業する必要はありません。以下をコピーして送っていただければ、話が通じます。
【現状を確認したいとき】
お世話になっております。
生成AIのクローラー(AI各社の巡回ロボット)について、
現状を確認したいので、下記を教えてください。

1. 当社サイトの robots.txt に、AI関連のユーザーエージェント
   (GPTBot / ClaudeBot / CCBot / Google-Extended / PerplexityBot など)
   の記述があるか。あれば、どれをどう指定しているか
2. サーバー側のセキュリティ機能やボット対策で、
   これらのクローラーを弾いていないか(403を返していないか)
3. 上記1と2が、当社の意図と一致しているか

背景:robots.txtで許可していても、サーバー側で
遮断されていて実際には読まれていない、というケースがあるため、
2点セットで確認したいという趣旨です。
【止めると決めたとき】
お世話になっております。
生成AIの学習用クローラーについて、下記の方針で
robots.txt の設定をお願いできますでしょうか。

・止める対象:(例)学習用のみ/検索用も含めて全部
・残す対象 :(例)検索用は残す

あわせて、次の2点にご注意ください。

1. noindex を併用しないこと
   (robots.txtでブロックすると noindex が読まれず、
    かえって検索結果から消えなくなるため)
2. 設定後、実際に反映されているかを確認いただきたいこと
   (書いたつもりで効いていない場合があるため)
⚠この確かめ方で分かるのは「ウェブの図書館」の収録状況だけで、AI各社が独自に回っている分は含まれません。それでも、「まったく読まれていない」に気づくには十分です。当社はこれで気づきました。
この3ステップは0円でできますが、その先のAI検索対策そのものを外に頼むかは別の判断です。外注が向く会社・向かない会社の分かれ目はGEO対策は外注か自社か|うまくいかない3つの条件と、実績の確かめ方で書きました。
「うちは、読ませるべきか止めるべきか」を一緒に整理します
この記事のとおり、答えは会社によって違います。何が公開されていて、実際に読まれているのか。まずそこを一緒に確かめるところから始めます。ITコーディネータが、判断の材料をそろえるお手伝いをします。
※ ITコーディネータ・酒井大輔が対応します。
※Claudeは、Anthropic社が提供する生成AIで、同社の商標です。当社は、同社の公認・提携先ではありません。
次に読む
よくある質問(FAQ)
QAIに学習されないようにする方法はありますか+
Q社員がChatGPTに入れた情報が学習されるのが心配です+
Q止めると、Google検索にも出なくなりますか+
Q入口に貼れば、確実に読まれなくなりますか+
Q念のため、両方の設定をしておけば安心ですか+
Q他の会社は止めているのですか+
Q設定にお金はかかりますか+
Q止めるかどうか、どう決めればいいですか+
Q著作権の観点ではどうなのですか+
まとめ
- 「AIに学習されたくない」には2つの心配があります。この記事は「自社のホームページを読まれる」ほうです。「社員が入れた情報」は別の記事で扱っています
- 止める方法はあります。ホームページの入口の貼り紙に、AI各社のロボット名を、1社につき2行ずつ書くだけ。費用は0円、作業は5分です
- ただし「止めた/止めていない」は、書いた内容だけでは決まりません。受付が実際にどうしているかを見てください
- 当社は1社も止めていないのに、2026年4月から5か月間、ウェブの図書館に1ページも置かれていませんでした。受付が「お断り」を返していました。原因はサーバー側の設定で、9月4日に直しました。9月分の目録では、91ページがふたたび置かれていました
- 日本の主要企業53社を実際に確認した結果、止めていたのは10社。上場している事業会社は38社中1社、新聞・通信社は8社すべてでした
- 止められないものが4つあります。すでに学習された分、他人が書いた自社の情報、口コミ、そして人がAIに頼んで読ませる場合です
- 止めると、下調べの段階で候補から消えます。集客だけでなく採用でも同じです。ただし当社は意図して止めた経験がないので、断定はしません
- 公開すべきでない情報が載っているなら、止めるのではなく消してください。止める設定より先に、載せないという選択があります
- 今日やることは3つ。①入口の貼り紙を見る ②実際に読まれているか確かめる ③3つから選ぶ。全部で10分、0円です